返回作品
基于机器学习的居民消费数据分析及可视化实现
创建于 2026 年 4 月 12 日
项目介绍
本项目是课程设计《基于机器学习的居民消费数据分析及可视化实现》的落地软件原型,按”一体化分析系统”而非零散脚本设计,覆盖从数据接入、数据治理、特征工程、建模预测到交互式可视化的完整链路。系统以 Streamlit 提供 Web 交互界面,同时配套 Jupyter Notebook 分析流程,兼顾课程设计展示、论文写作截图与后续扩展真实数据三类需求。
项目默认内置一份”报告版结构数据集”:它不是纯随机演示表,而是以真实省级居民收支面板为校准基础生成的模拟结构数据集,字段已覆盖开题报告对消费结构分类的全部要求。真实参考面板整理自国家统计局公开数据,包含 31 个地区 1978—2021 年的 1274 条年度记录,可供消费水平预测与城乡差异分析使用。
核心功能
- 多源数据接入与治理:支持 CSV / XLSX / XLS 单表或多源三表(消费支出、宏观经济、人口统计)上传,兼容”日期""地区""人均可支配收入”等中文字段别名;按地区分组插值填补缺失值、1% / 99% 分位数裁剪异常值,重算总消费与八大类消费占比。
- 特征工程:自动构造恩格尔系数、服务型消费占比、消费升级指数、收入与消费环比增速、滞后 1 期消费、近 3 期消费均值、近 6 期收入均值及月份周期正弦 / 余弦等模型特征。
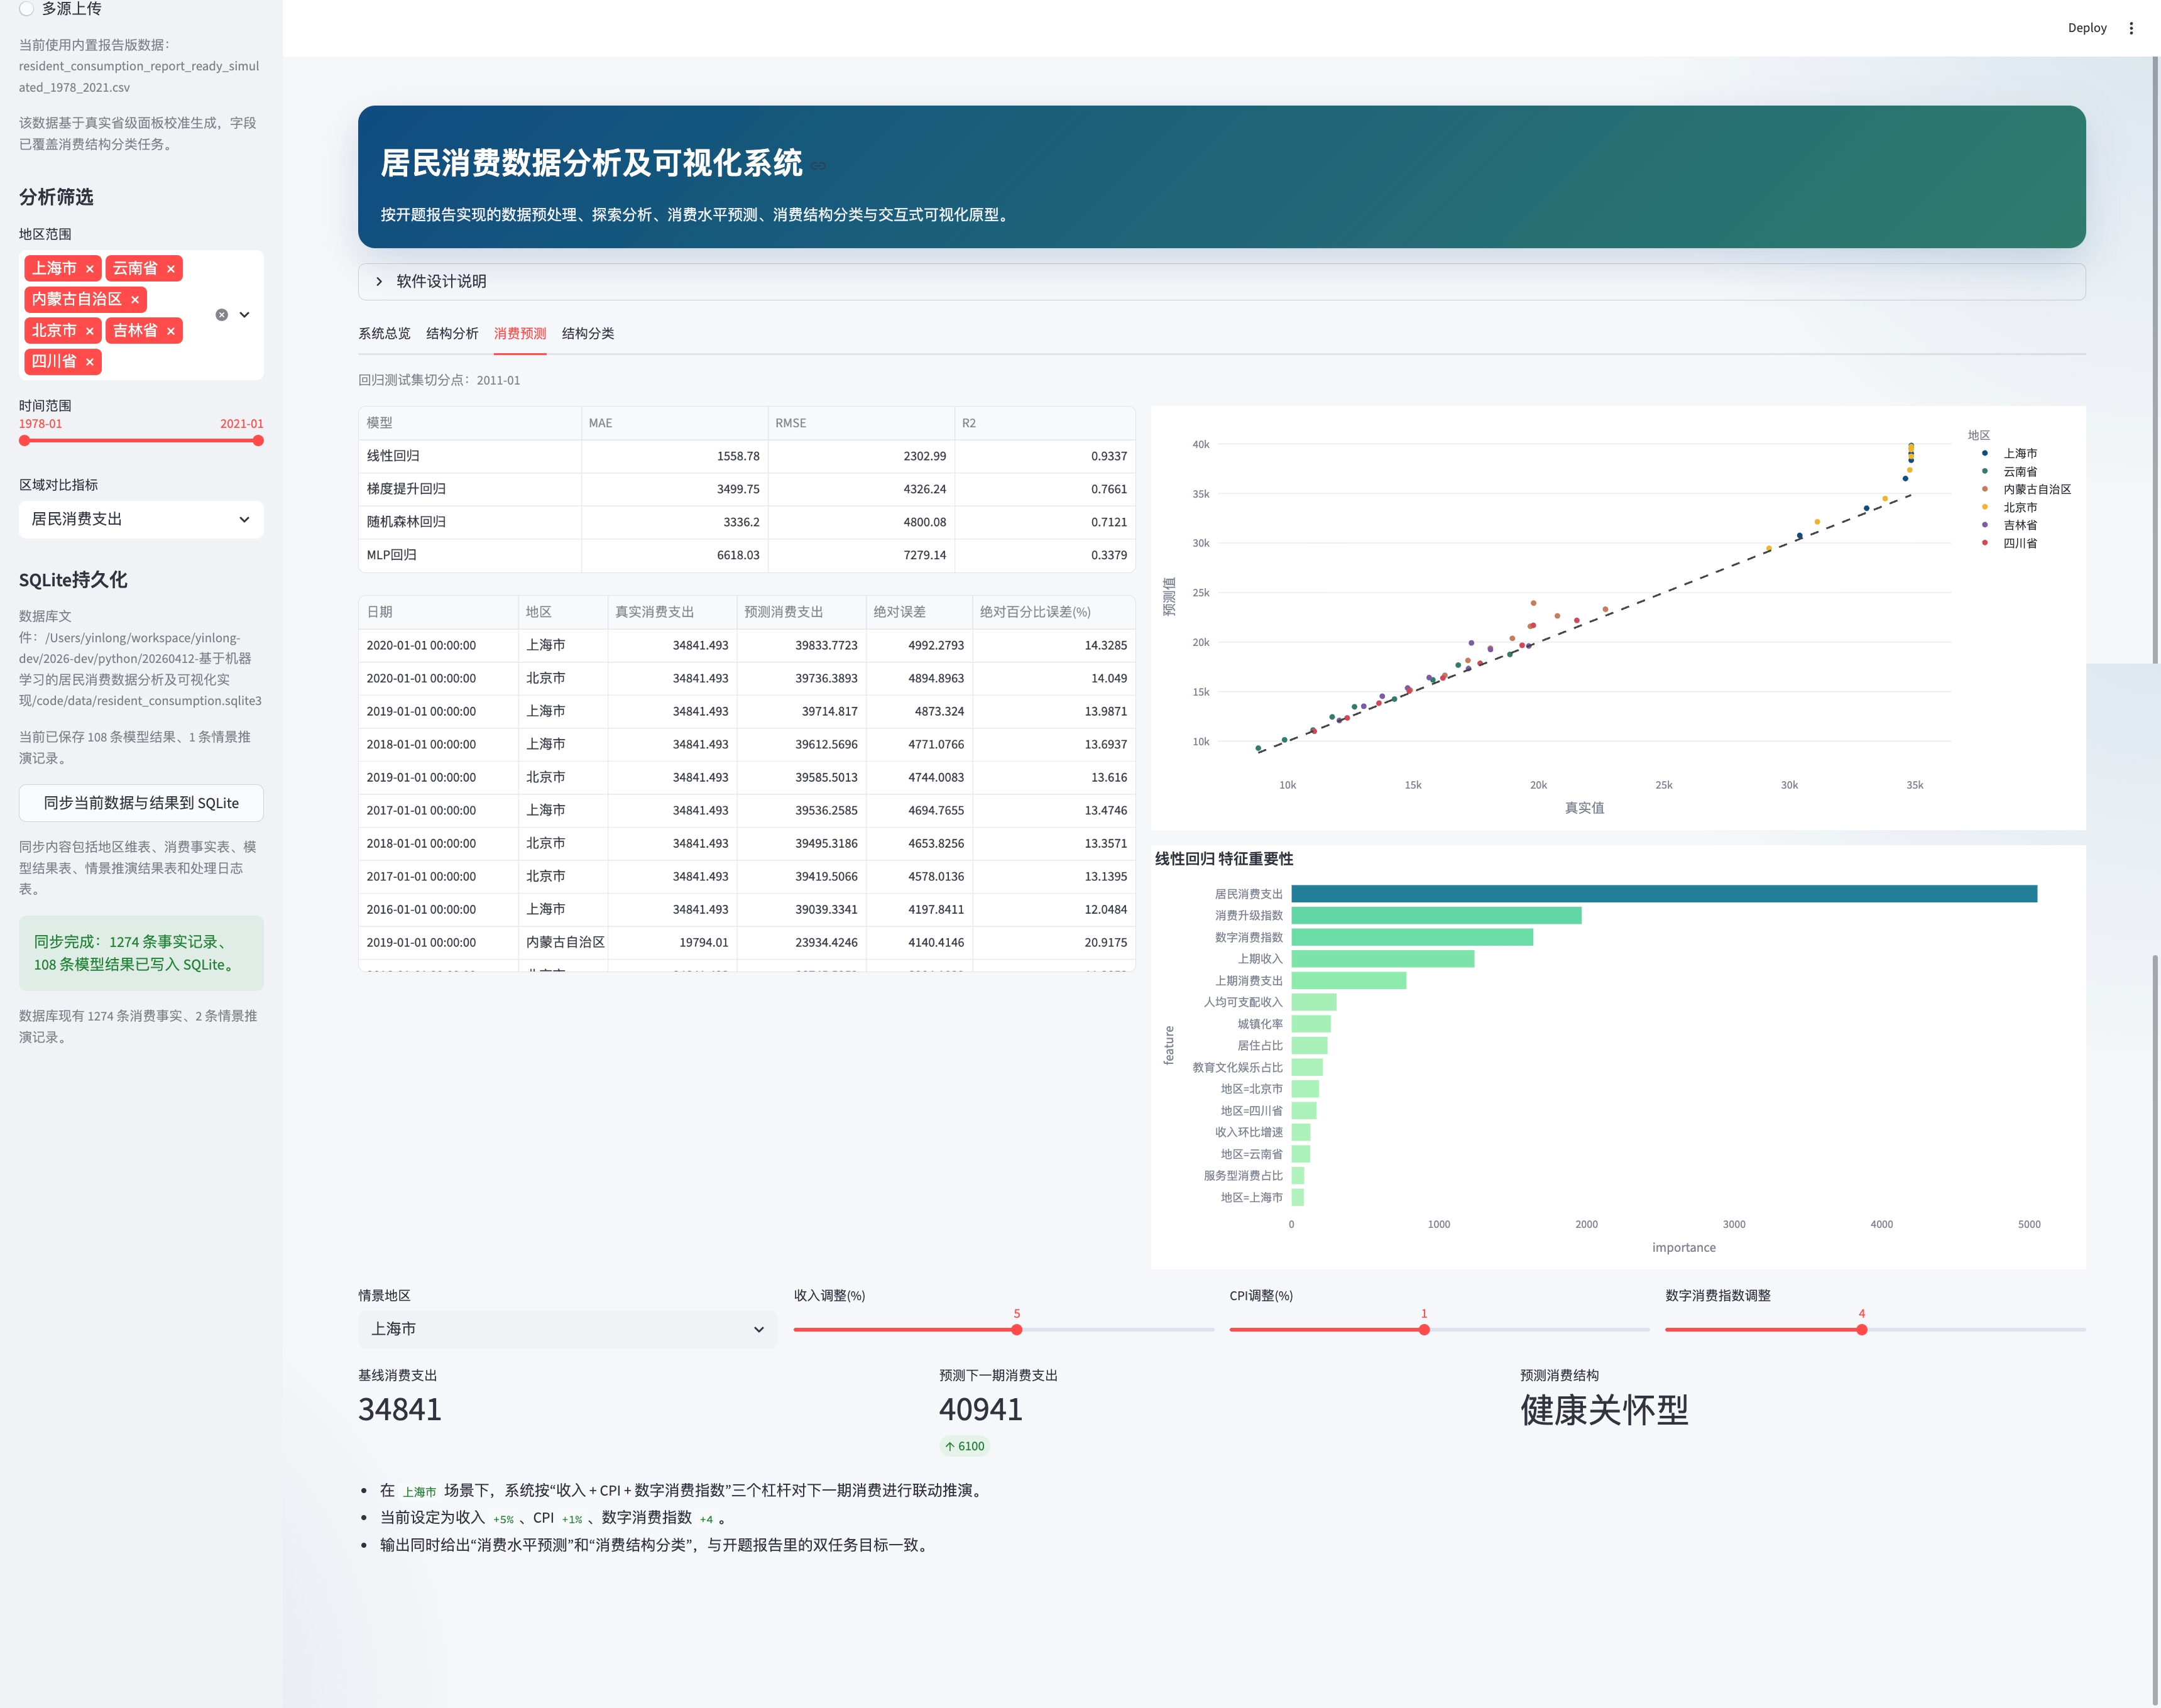
- 消费水平预测:线性回归、随机森林、梯度提升、MLP 四类回归模型在同一时间切分(后 20% 期数作为测试集)下对比 MAE、RMSE、R²,自动选出最优模型并展示特征重要性。
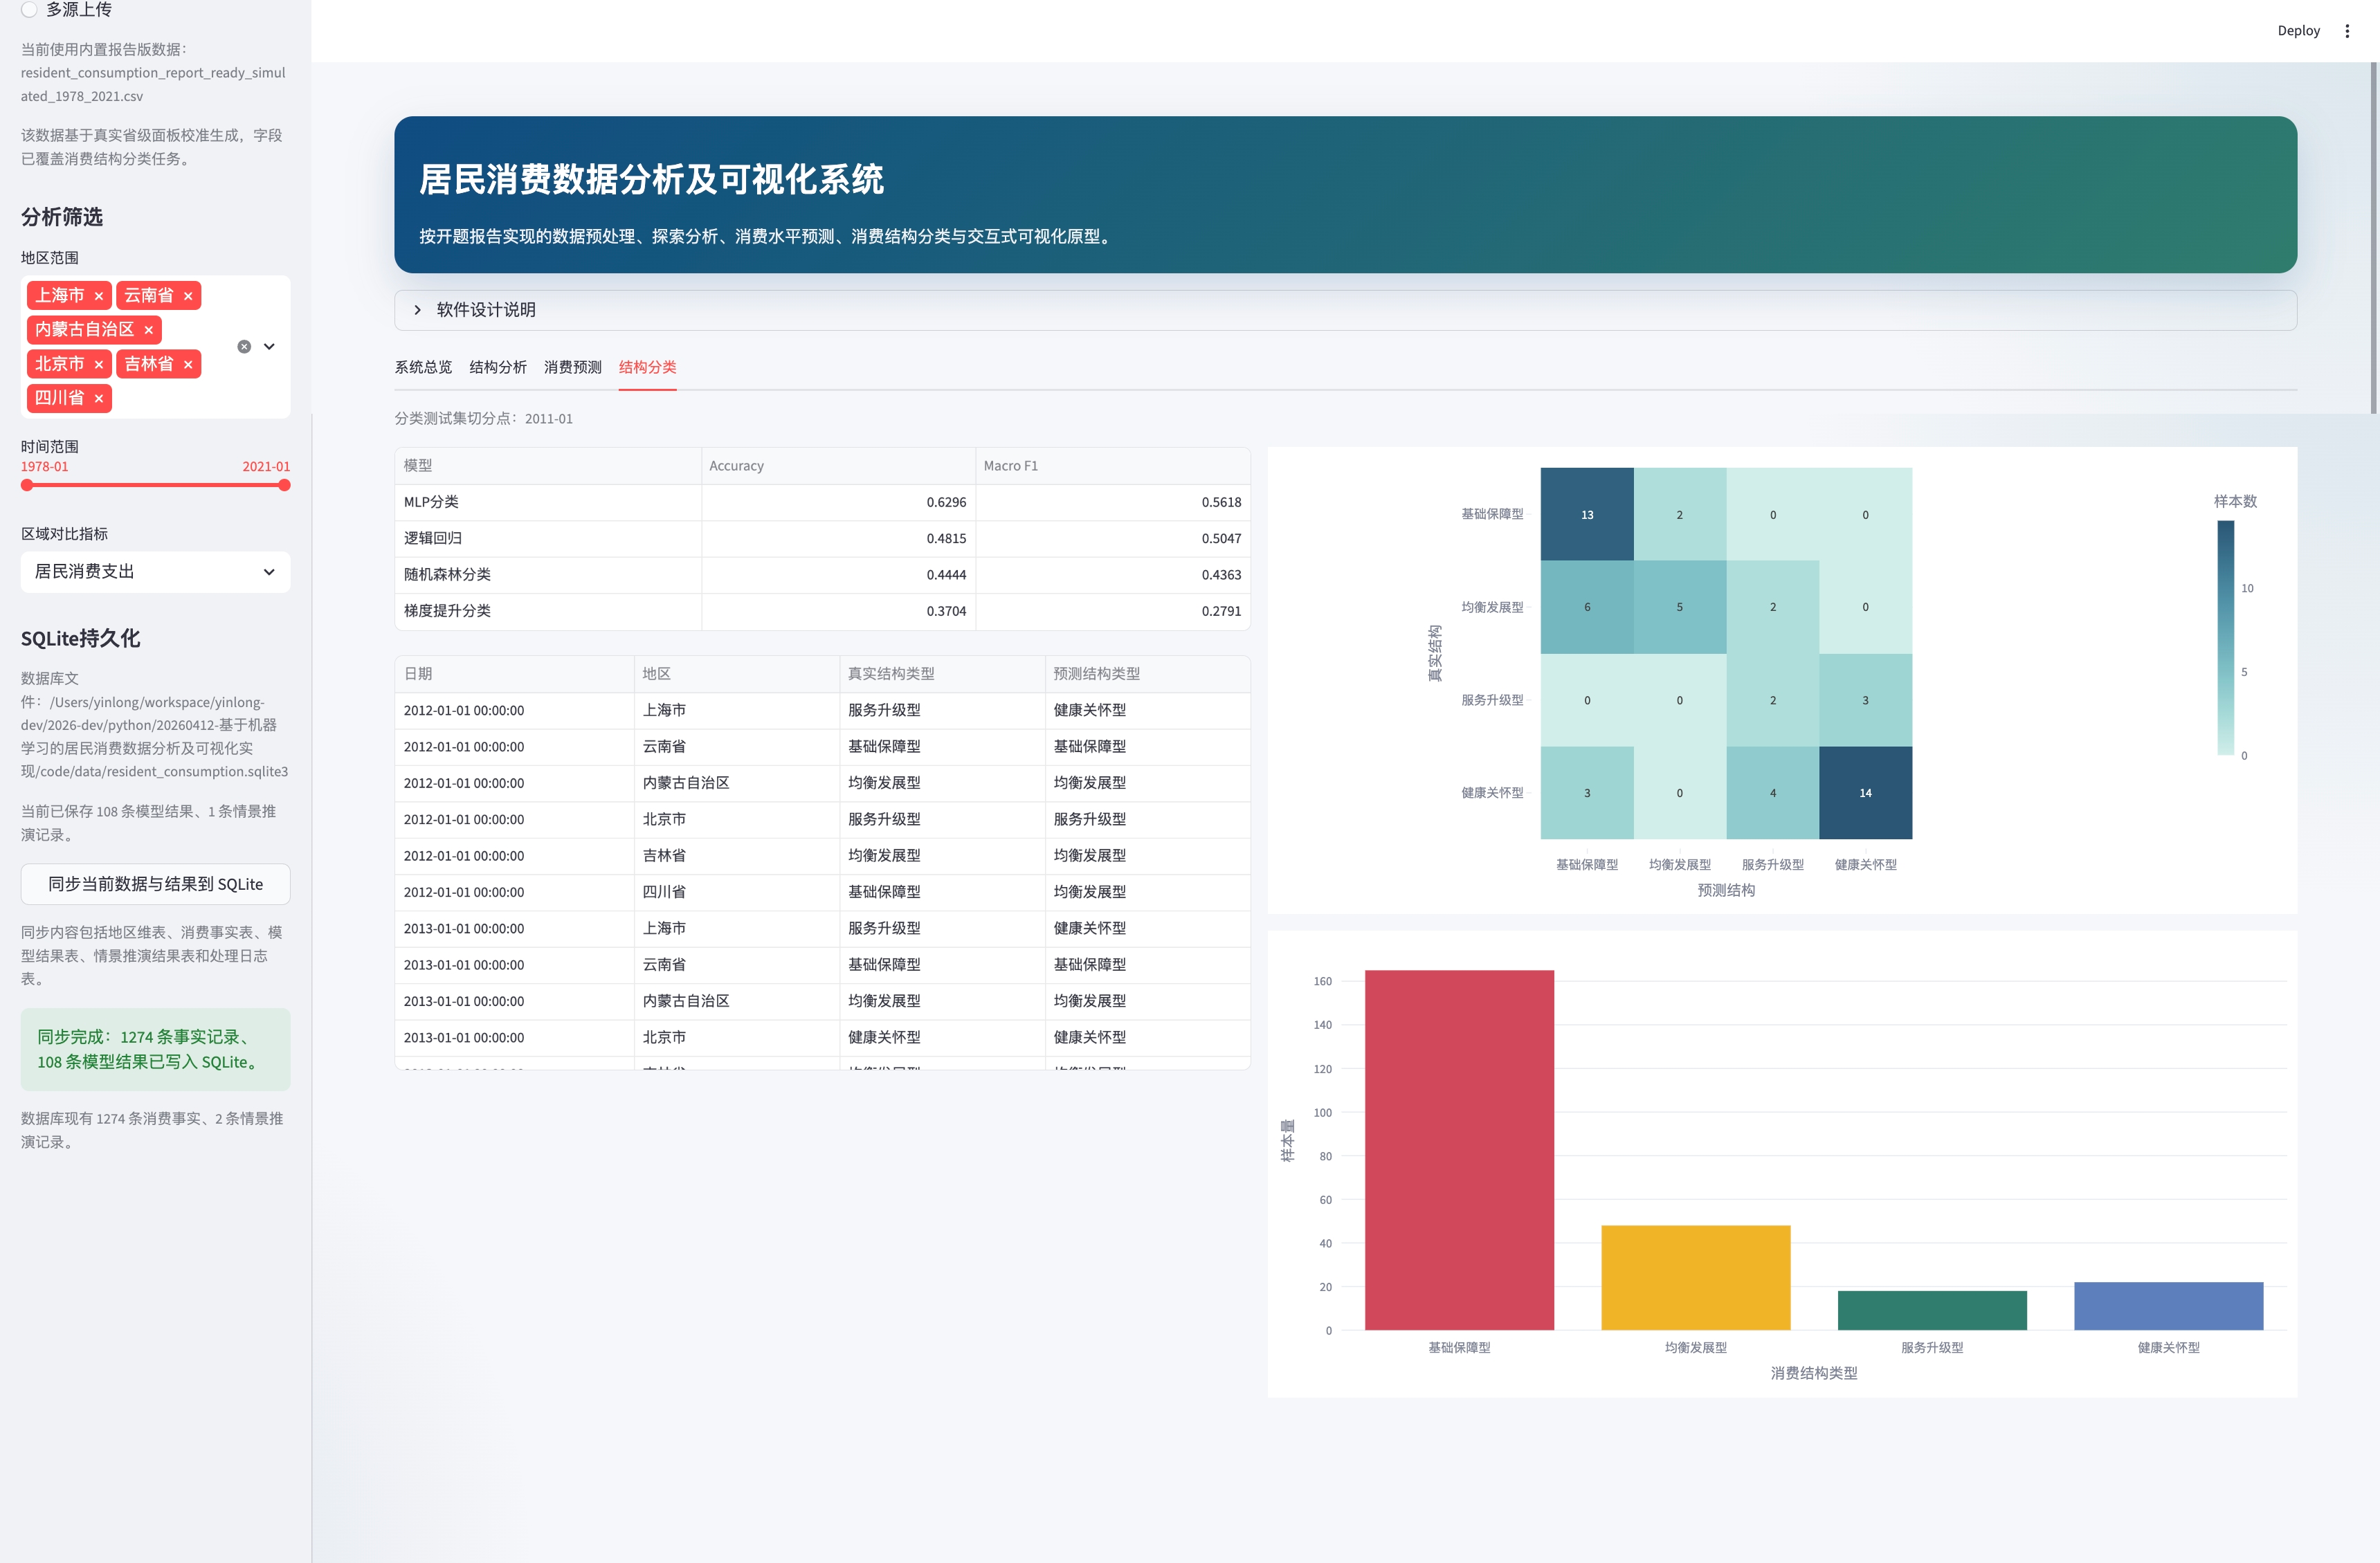
- 消费结构分类:基于恩格尔系数、食品居住占比、服务型消费占比、医疗占比与老龄化比重,将消费结构划分为基础保障型、均衡发展型、服务升级型、健康关怀型四类,用逻辑回归、随机森林、梯度提升、MLP 建模并输出准确率、Macro F1 与混淆矩阵。
- 情景推演:在界面上调整收入增速、CPI 与数字消费指数,即可即时输出下一期消费支出预测值与消费结构类型。
- 结果持久化:一键将地区维表、消费事实表、模型结果表、情景推演结果表和处理日志表同步到 SQLite,数据库也可反向作为系统数据源。
功能截图
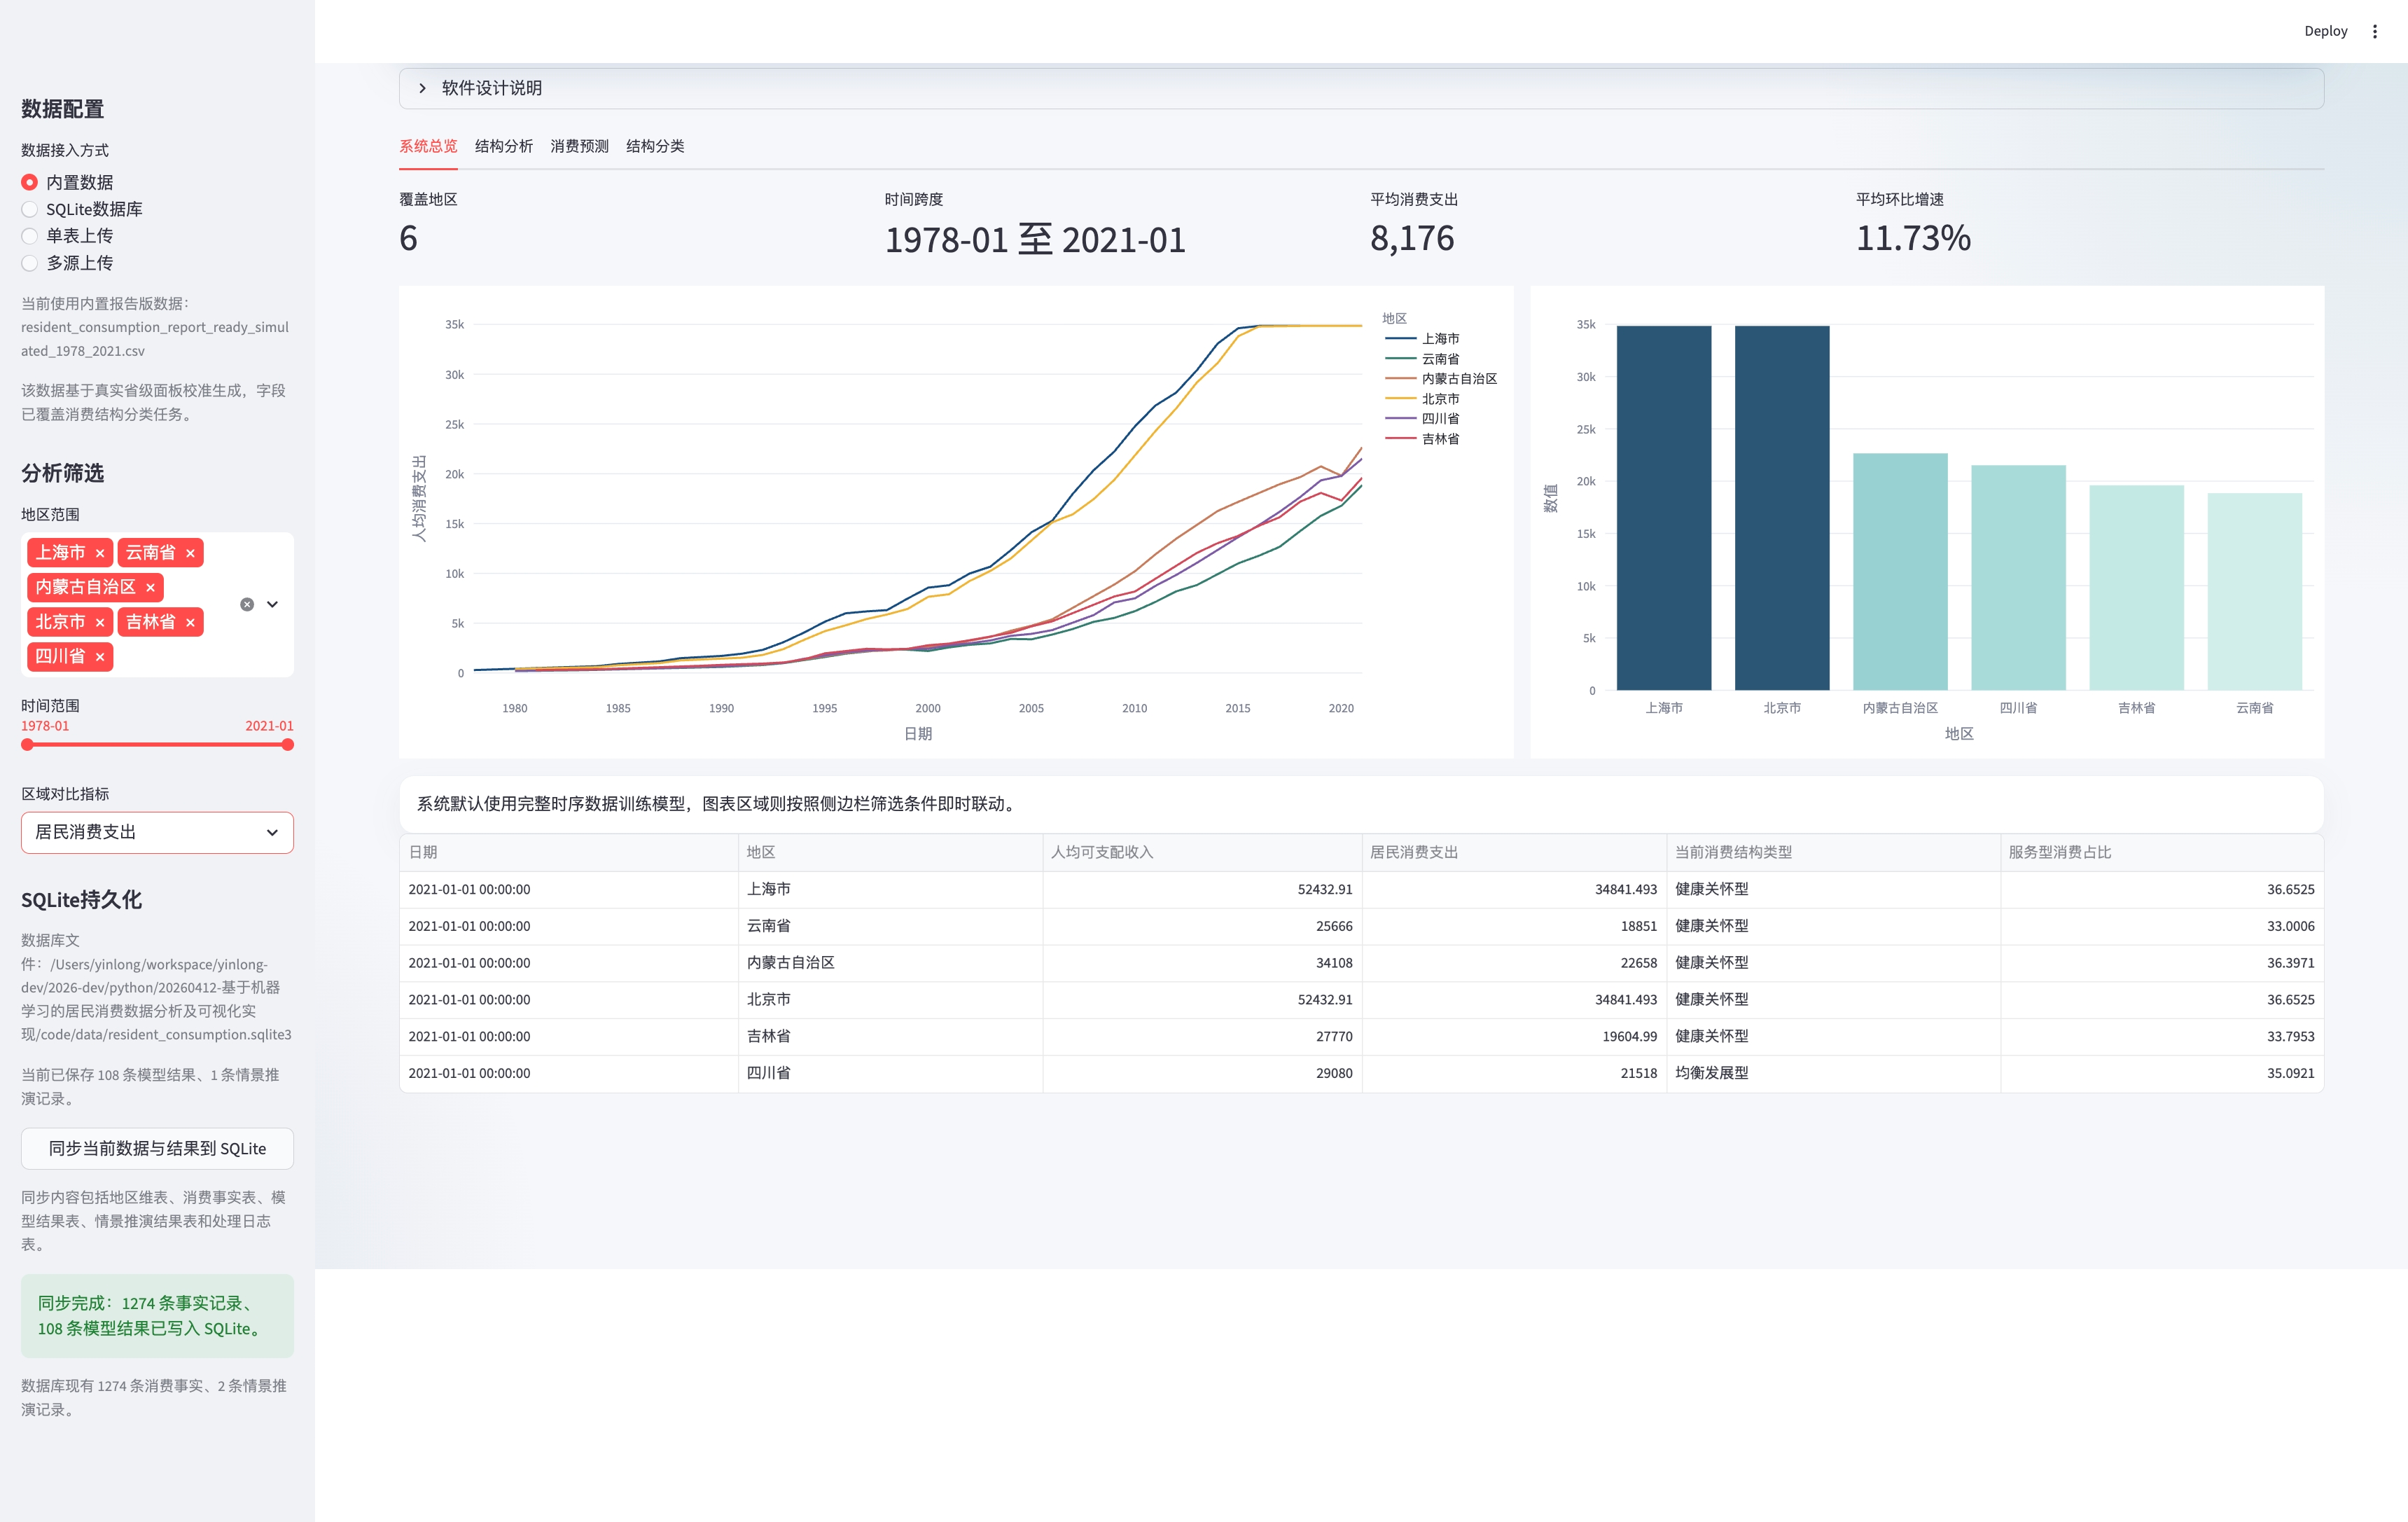
系统总览与消费预测
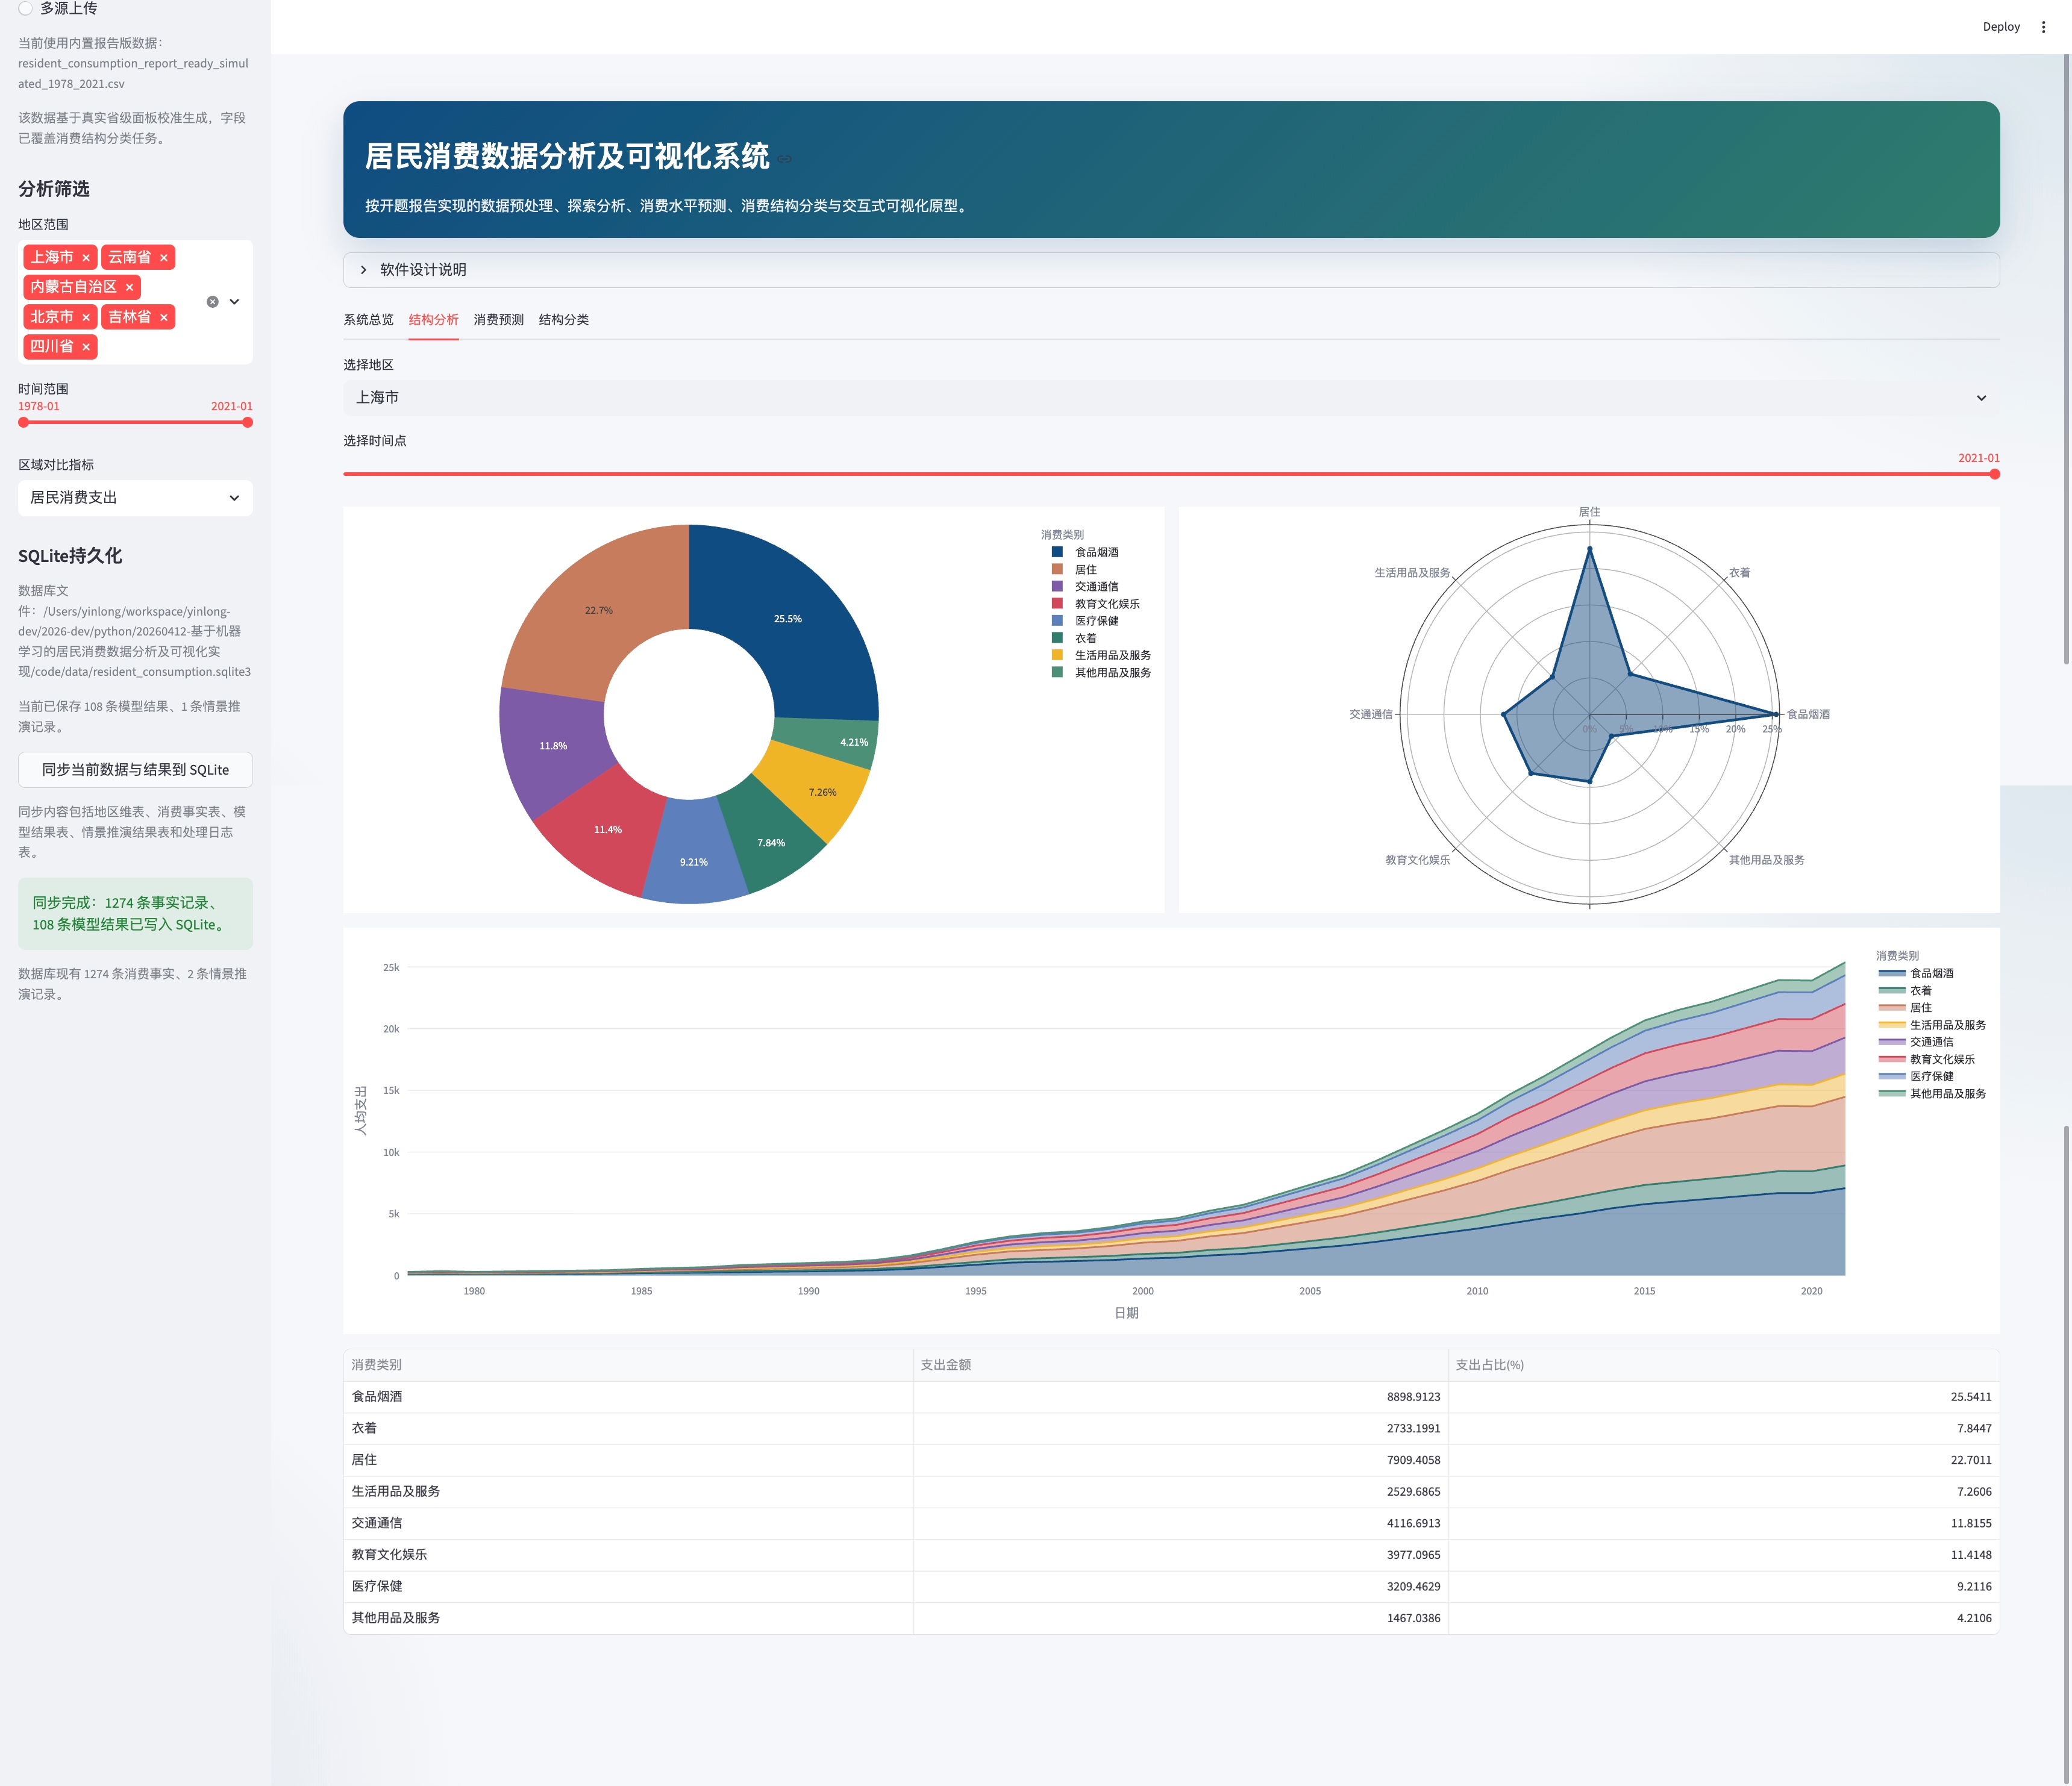
消费结构分析