基于 LDA 主题模型的手机用户评论情感分析及可视化
创建于 2026 年 4 月 1 日
项目介绍
手机厂商和电商平台每天都在产生海量用户评论,但这些评论大多是非结构化文本,直接阅读既耗时又难有全局结论。本项目针对京东手机评论数据,构建了一条从原始 CSV 到主题洞察的完整分析链路:先通过导入服务完成编码识别、字段映射与去重入库,再进行文本清洗、语言判定与 jieba 分词,接着用规则词典完成情感打分,最后用 LDA(Latent Dirichlet Allocation)主题模型把数千条评论收敛为若干个可解释的主题,并通过 FastAPI 接口与 ECharts 大屏把结论呈现出来。
项目是”可落地”而非”纯演示”的设计:数据按接入层、原始层、标准层、分析层四层入库(MySQL),每次分析运行都会留下完整的模型元信息(候选主题数得分、一致性、困惑度、主题关键词、主题名置信度),大屏上可以看到每一次训练 run 的 id 与主题数。系统还支持在线下载公开数据、补全商品的价格段与发布时间等元数据,并能按周期定时重跑分析,适合持续跟踪评论舆情变化。
技术栈上,后端采用 Python 3.11 + FastAPI + SQLAlchemy 2.0 + MySQL 8.0,分析部分使用 scikit-learn 的 LatentDirichletAllocation 与 jieba 分词,前端大屏使用 ECharts 5。整个项目可以用一条命令从建表跑到出图,也可以分步执行以便调试。
核心功能
CSV 导入与去重入库。按 datasets.yml 中的数据集定义(编码、分隔符、字段映射、清洗规则)读取评论 CSV,自动识别品牌与机型(从商品 URL slug 或标题提取),用机型 + 昵称 + 时间 + 正文的联合键去重,入库前计算 sha256 校验和,重复文件直接跳过,并记录每次导入批次。
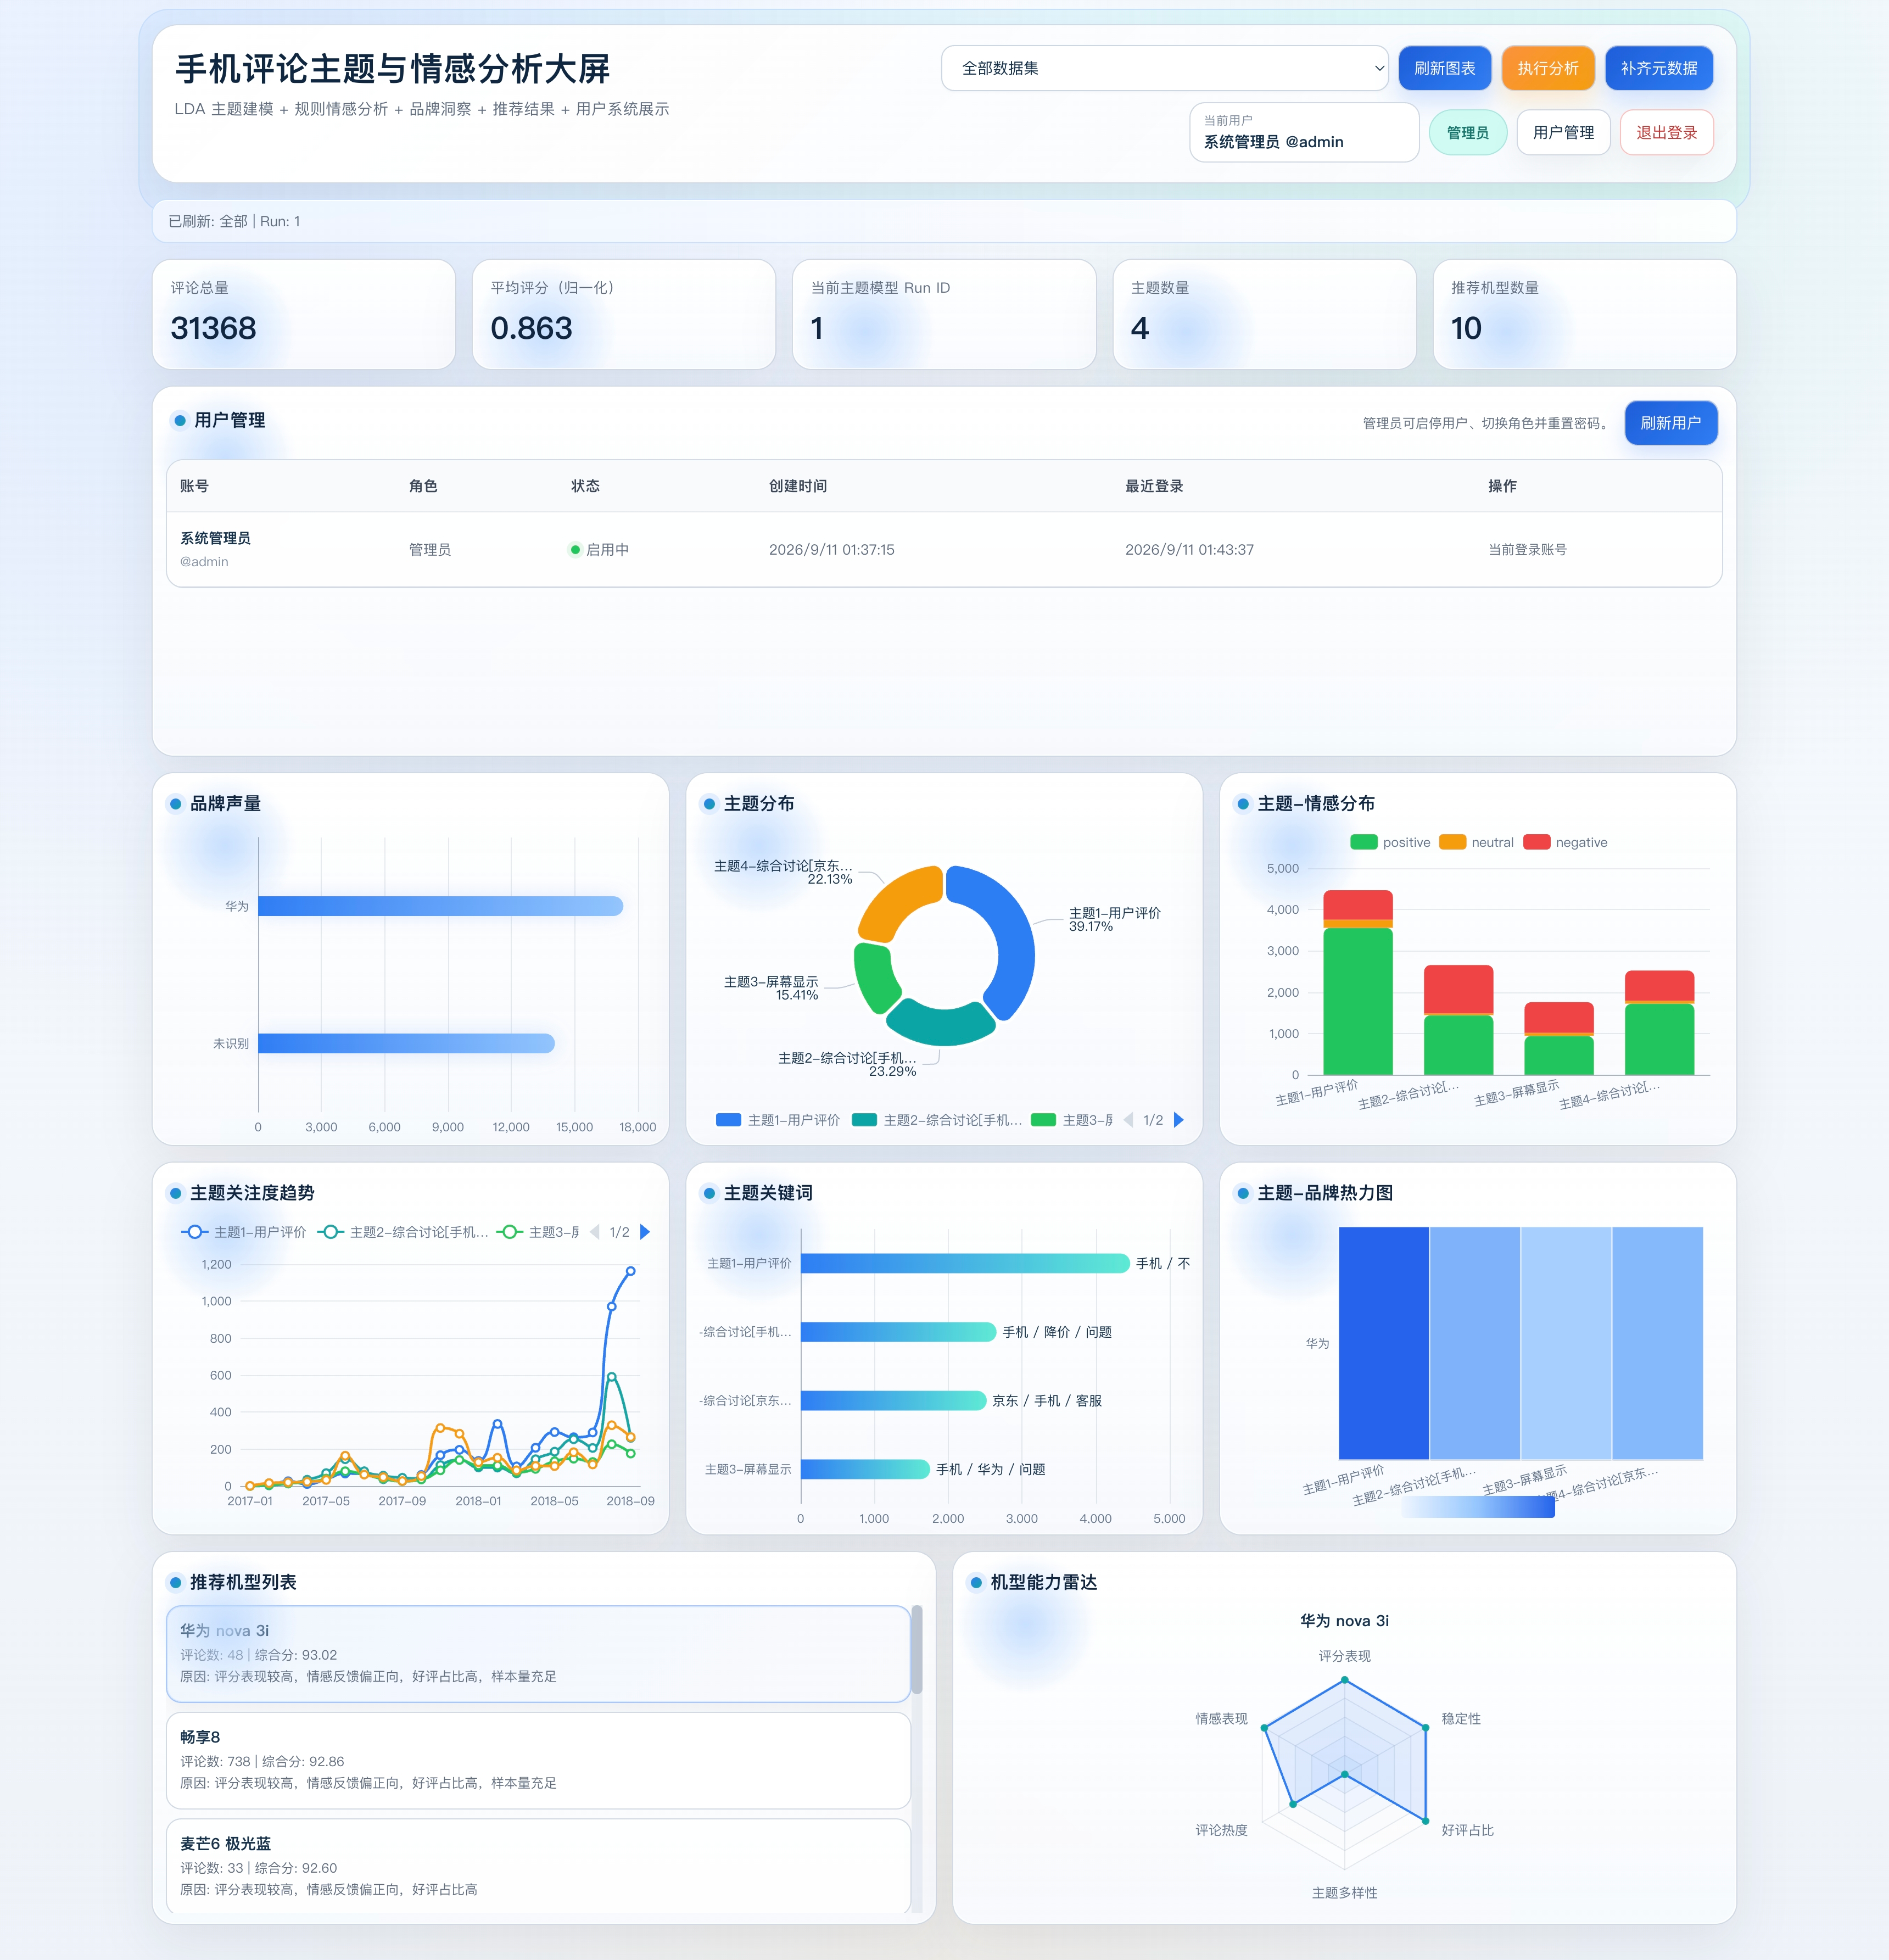
可视化大屏与任务触发。大屏以指标卡 + 8 张图表呈现:品牌声量、主题分布、主题情感、主题关注度趋势、主题关键词、主题-品牌热力图、推荐机型列表、机型雷达(联动)。页面内置登录/注册与管理员用户管理,支持在页面上直接触发”执行分析”与”补齐元数据”任务。配套脚本还支持在线下载数据(CSV/ZIP/GZ)、元数据补齐(价格段/发布时间)与定时调度(按分钟周期自动重跑导入与分析)。
功能截图