返回作品
基于学生数据的可视化与发展潜力评估预测
创建于 2026 年 2 月 28 日
项目介绍
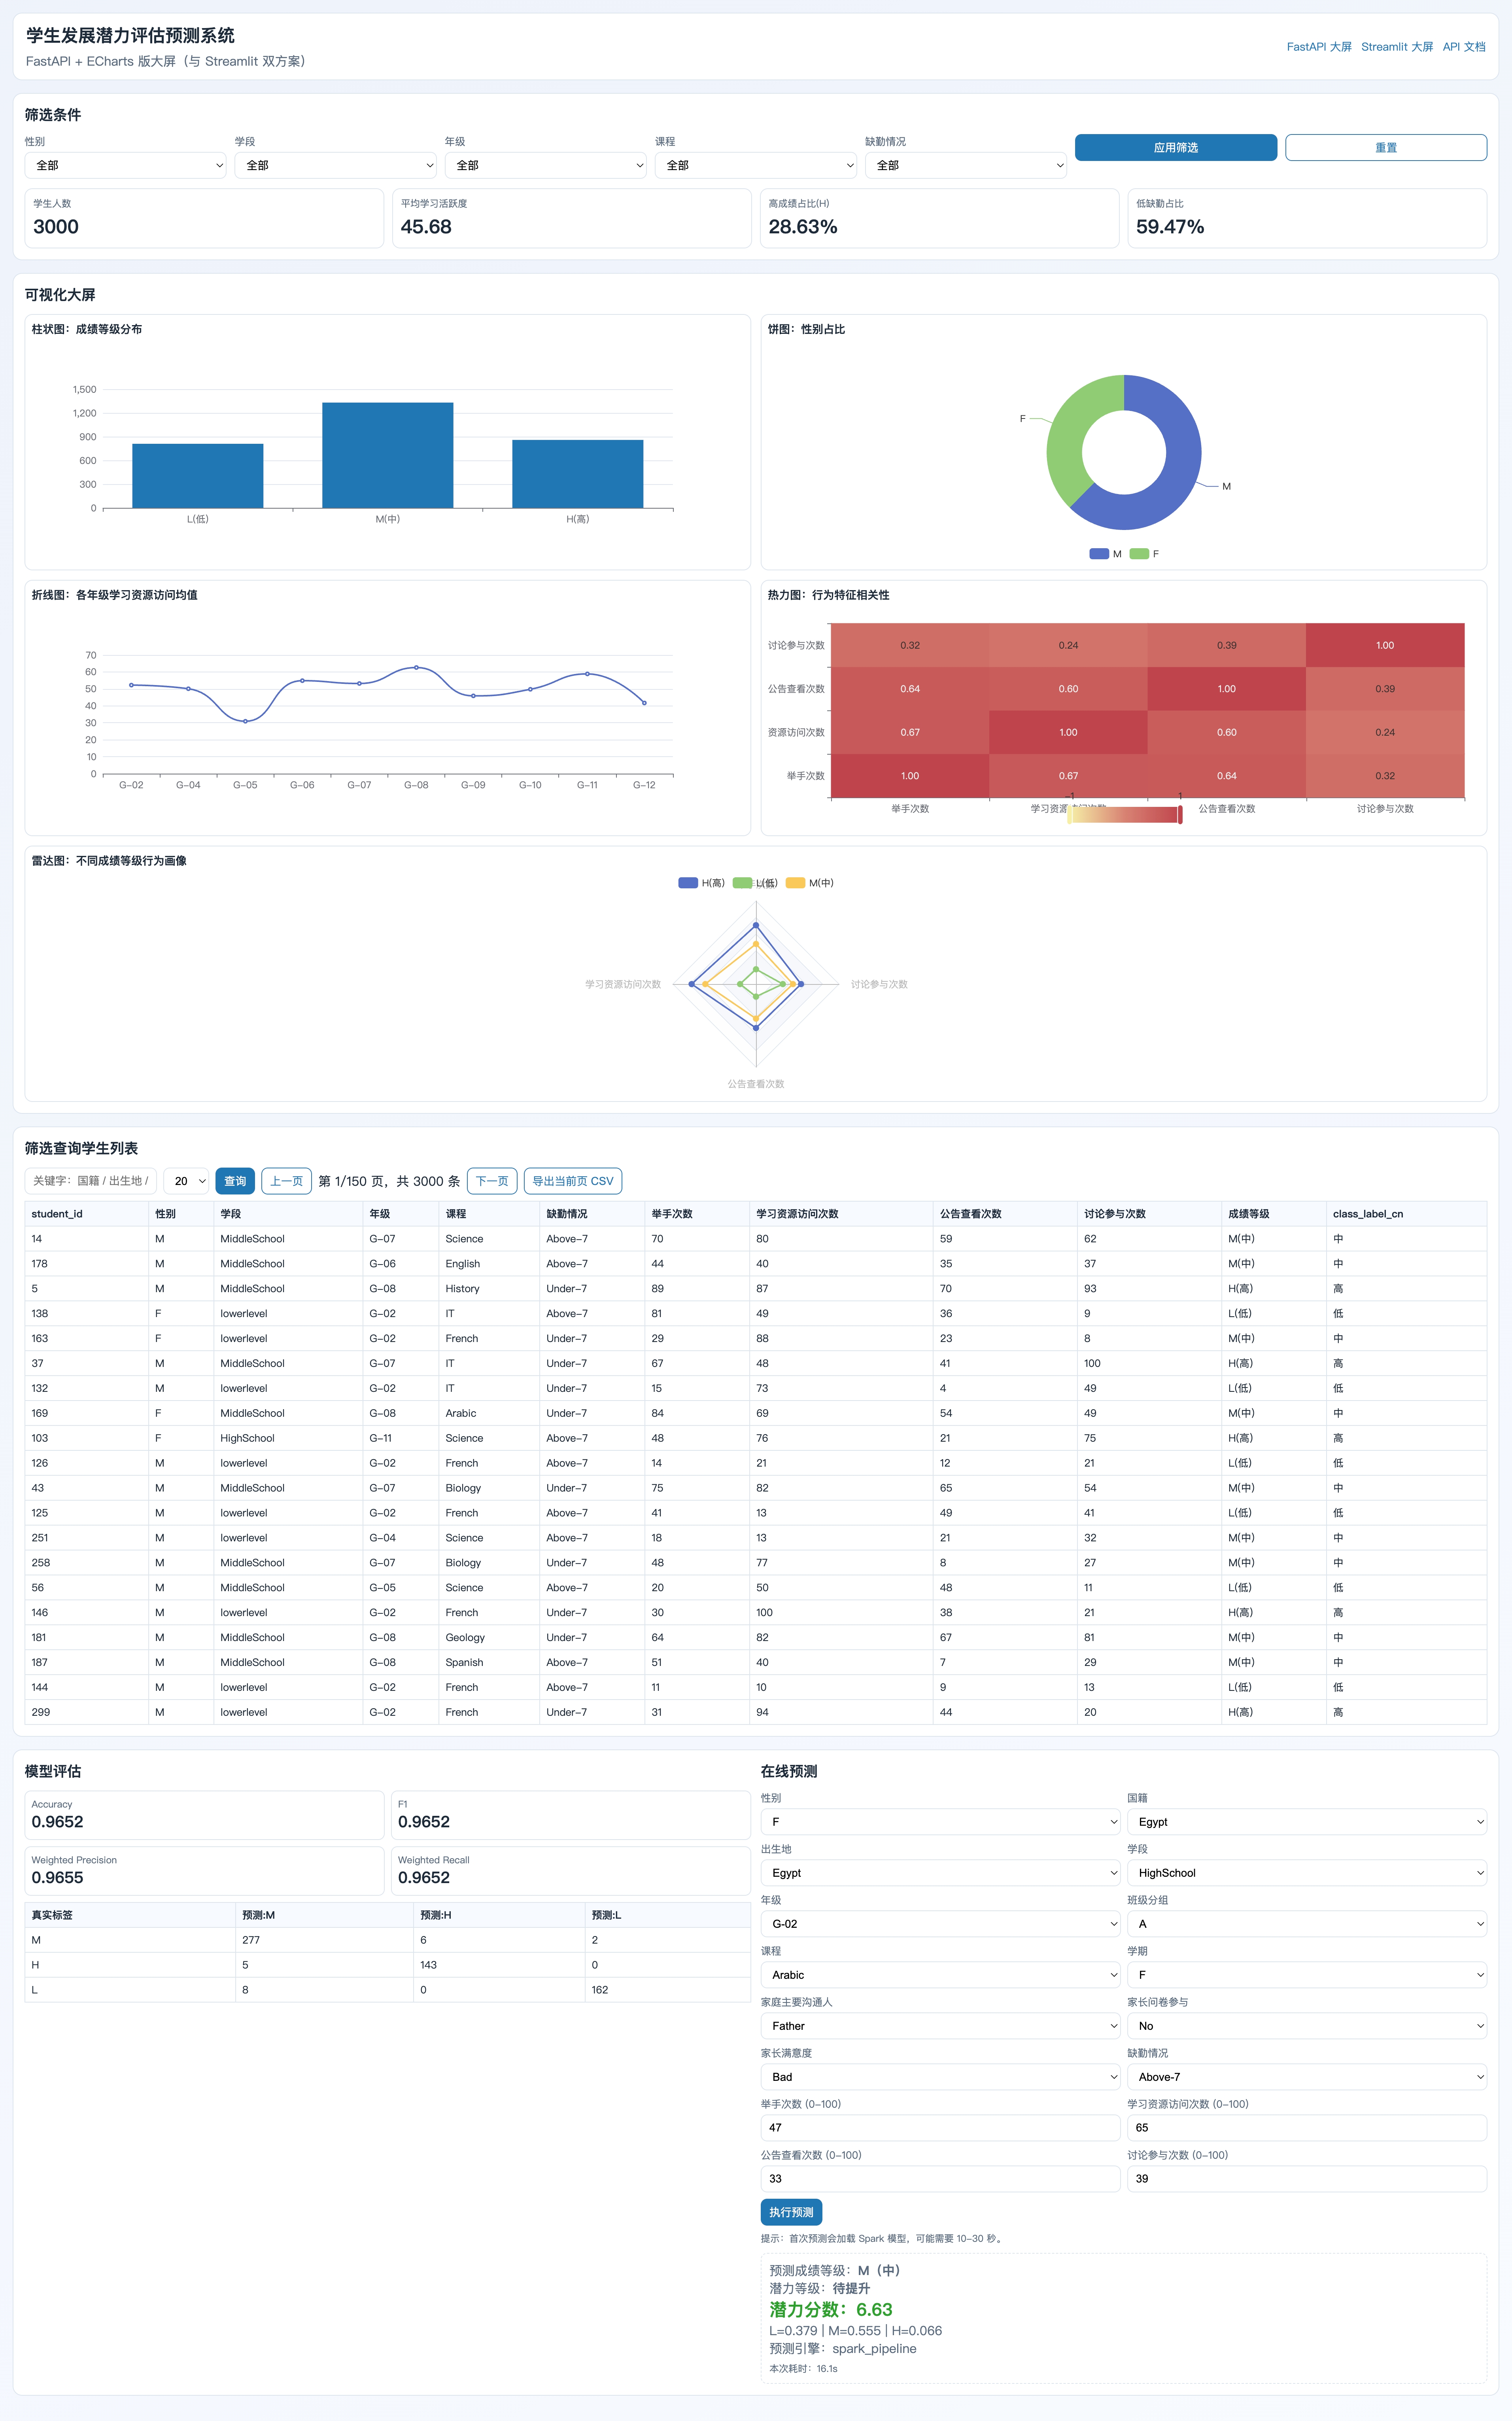
本项目是一个面向学生成绩数据的”分析 + 预测”一体化系统,目标是把一份小规模种子成绩表,加工成可训练、可展示、可预测的完整数据产品。系统以 PySpark + Spark MLlib 作为数据清洗与建模引擎,数据从 docs/学生成绩预测.xlsx 出发,经过扩充、清洗、训练三步流水线后,同时由两套 Web 方案对外服务:Streamlit + Plotly 版主打快速交互,适合课堂演示与探索式分析;FastAPI + ECharts 版采用前后端分离结构,提供一组 JSON API,适合接口化部署与二次集成。
核心功能
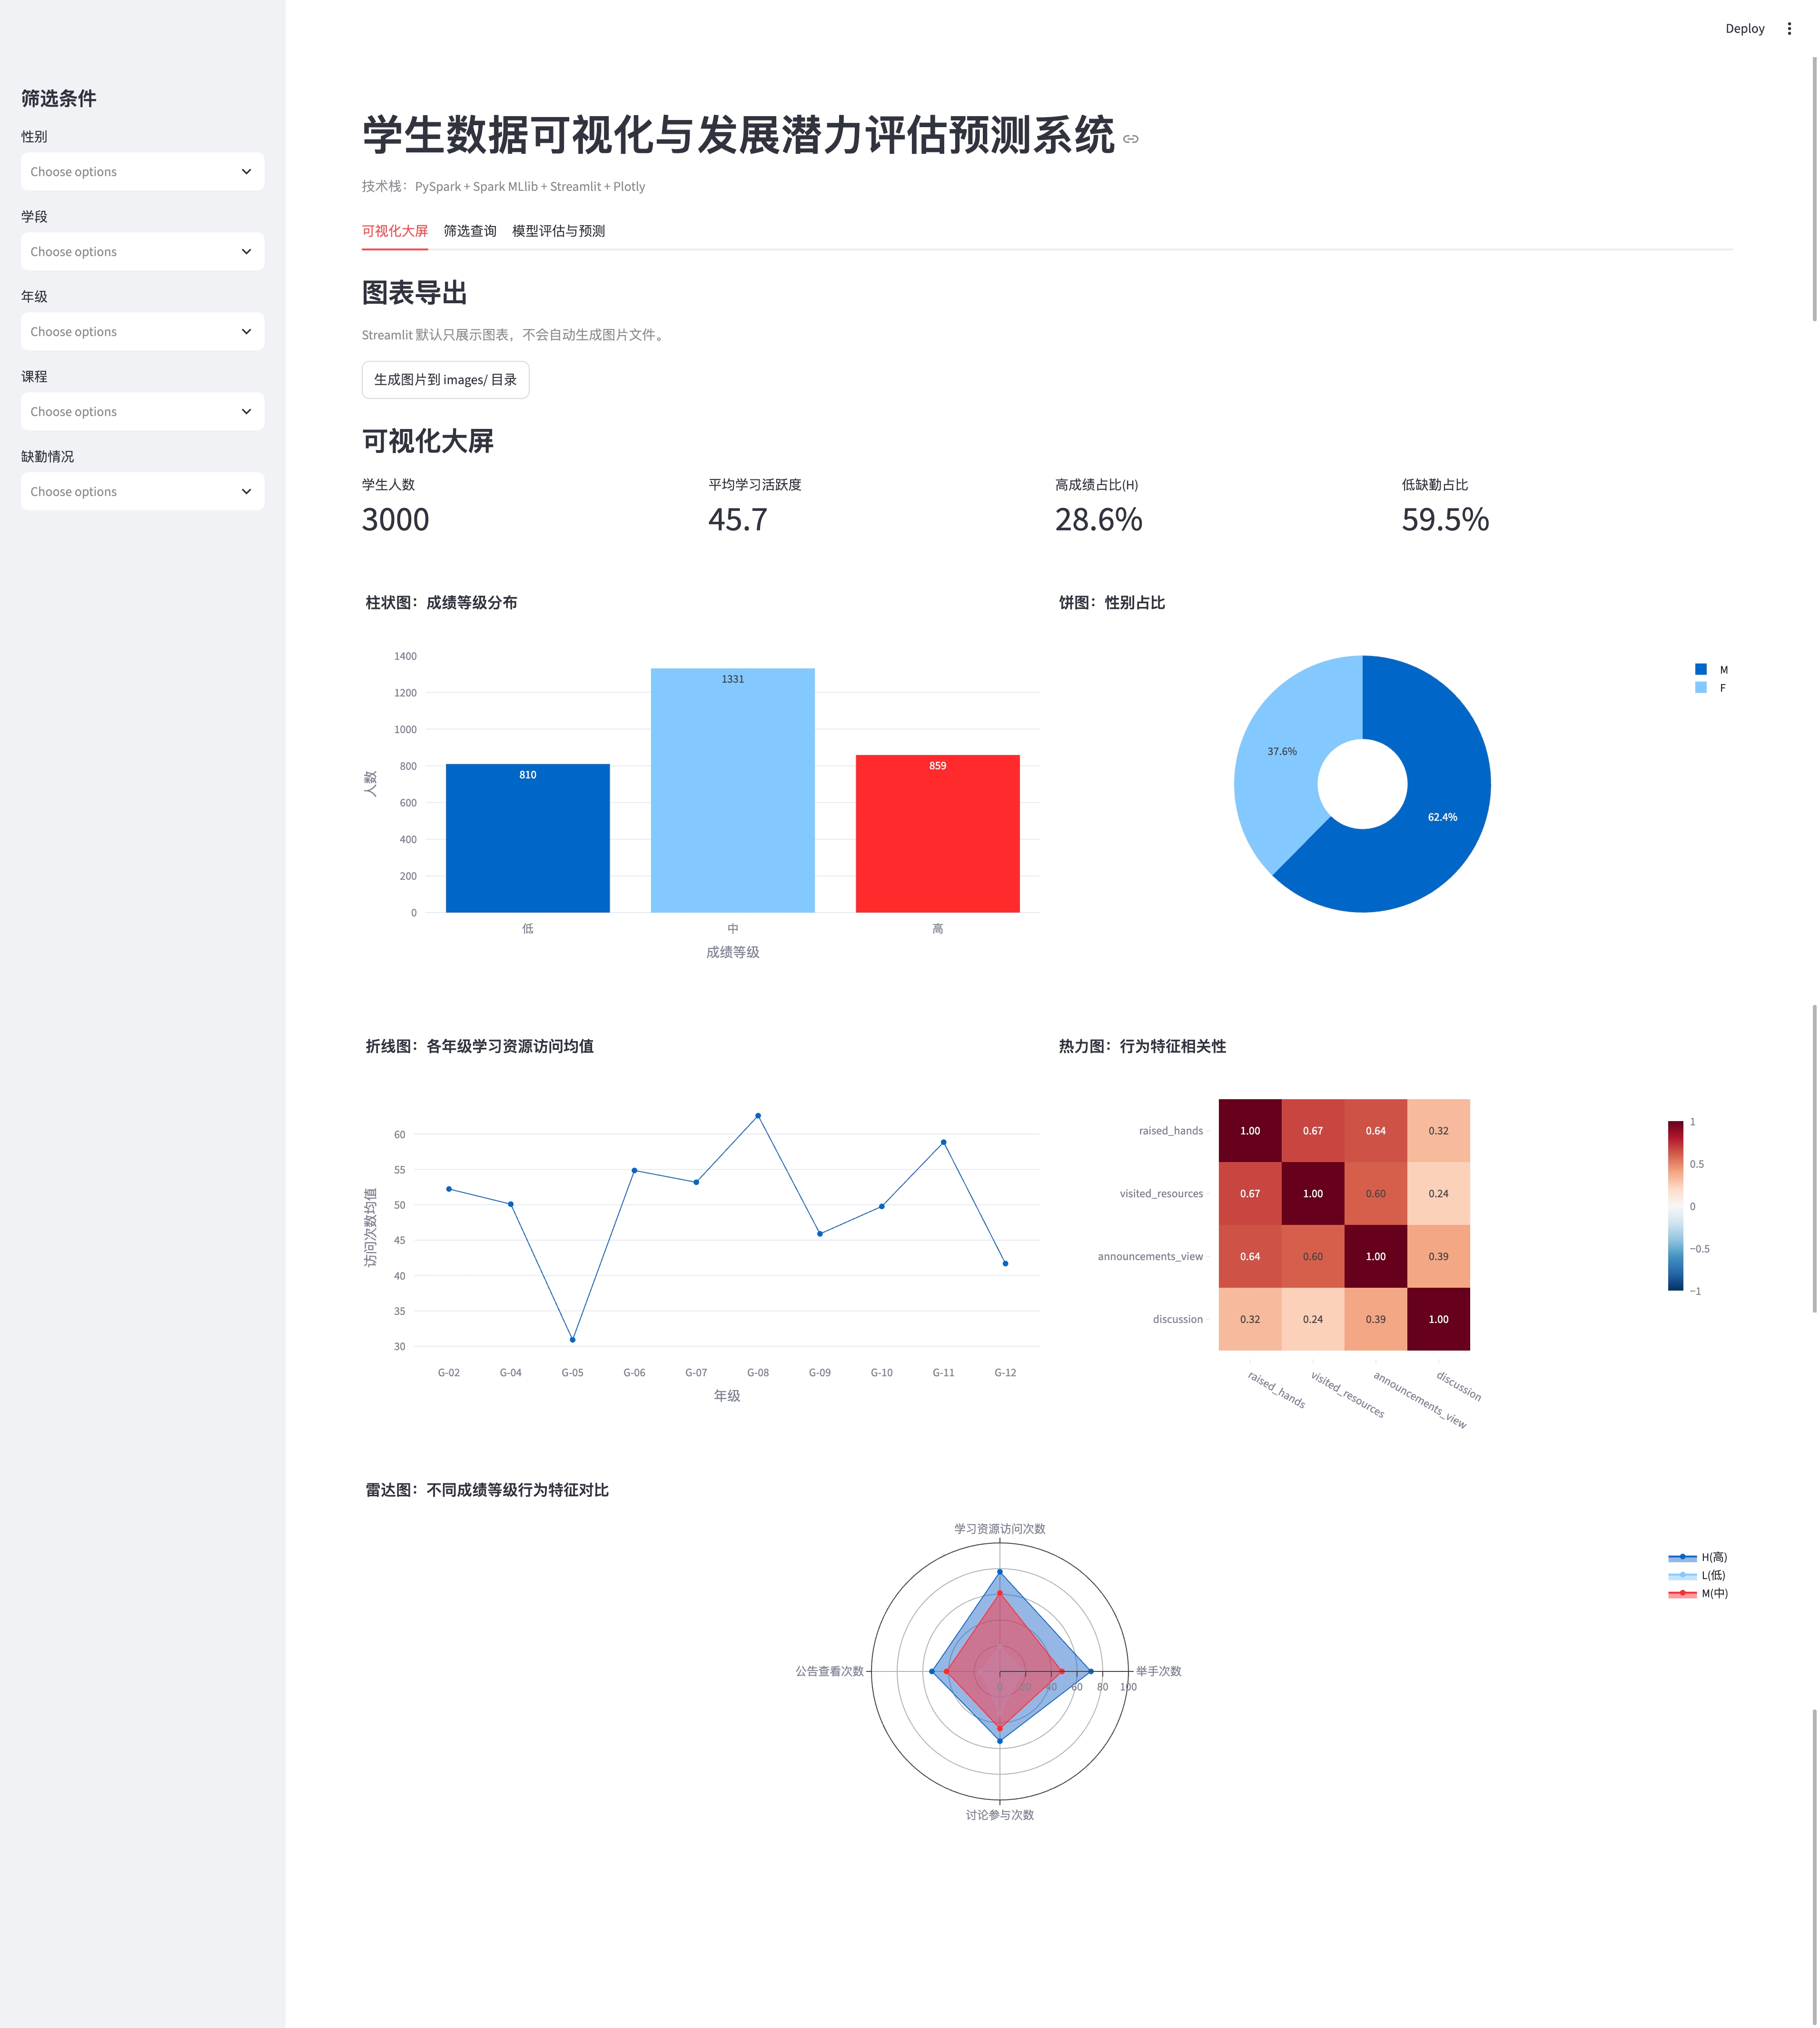
- 可视化大屏:四张 KPI 卡(学生人数、平均学习活跃度、高成绩占比、低缺勤占比)+ 五类图表——成绩等级分布柱状图、性别占比饼图、各年级学习资源访问均值折线图、行为特征相关性热力图、不同成绩等级行为画像雷达图;Streamlit 版支持侧边栏多选联动筛选,并可在页面内一键将图表导出为
images/*.png。 - 学生筛选查询:支持性别、学段、年级、课程、缺勤情况多维度筛选,叠加国籍 / 出生地 / 课程关键字检索,分页表格展示,一键导出当前筛选结果 CSV。
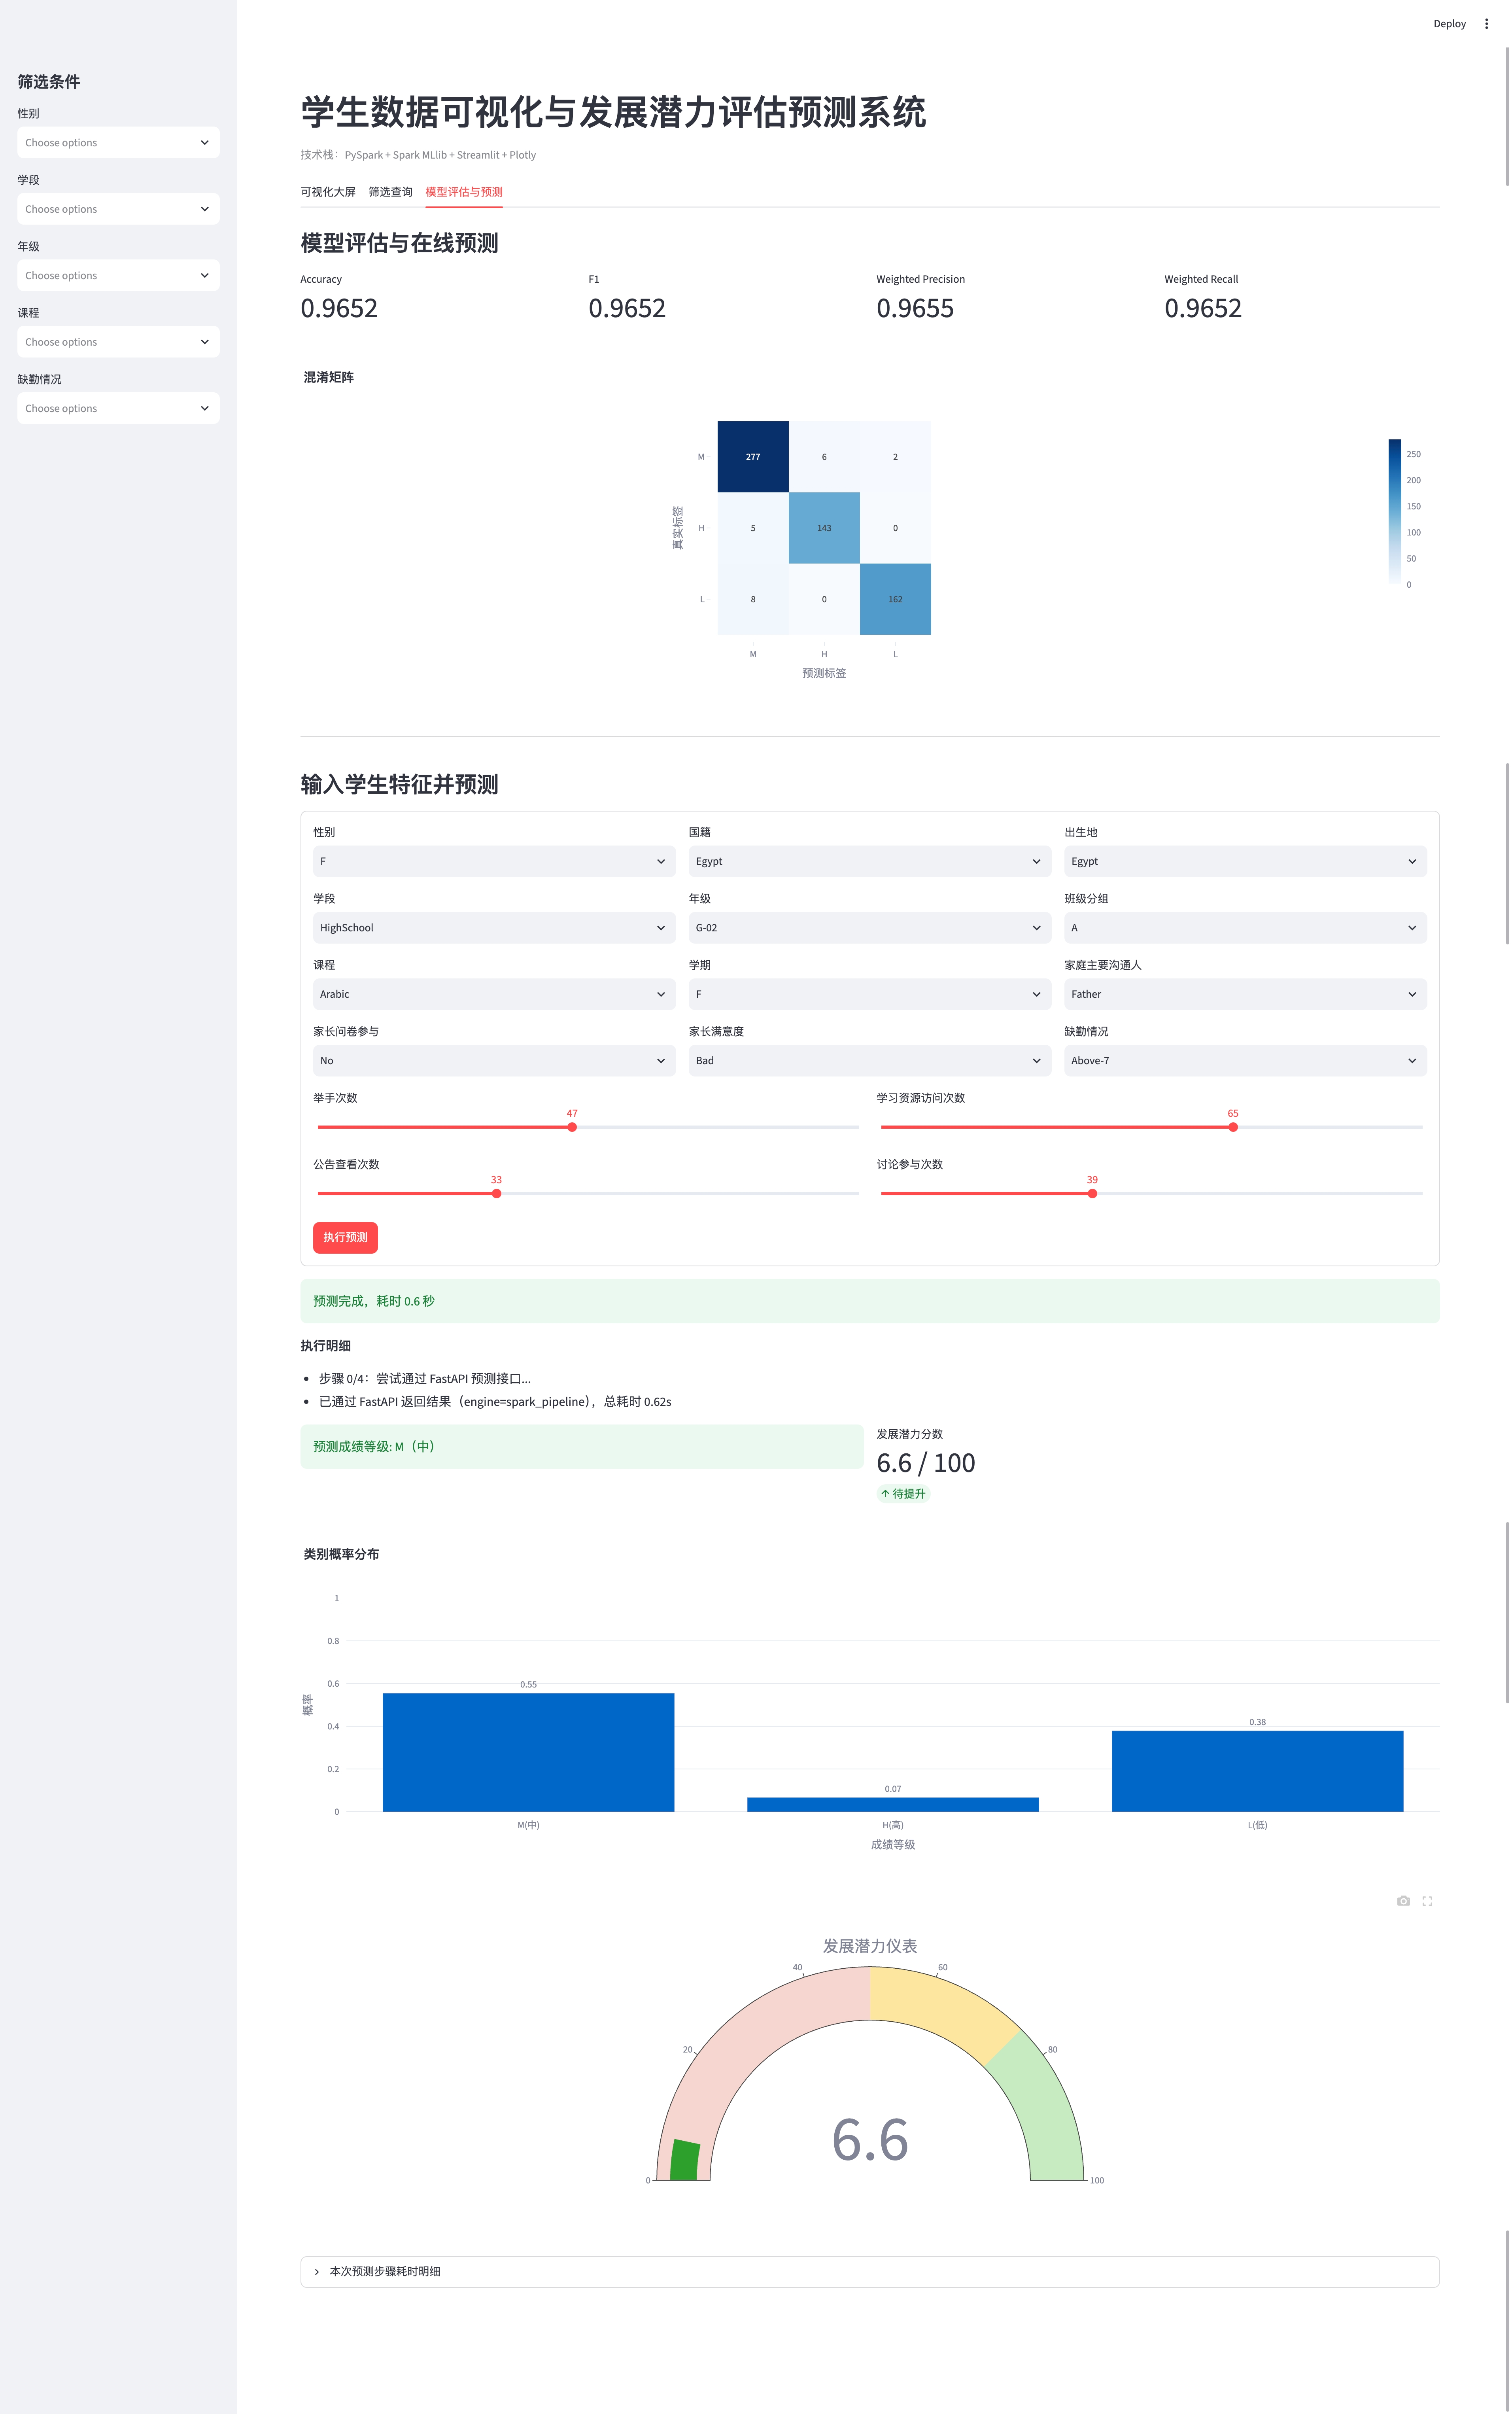
- 模型训练与评估:Spark ML Pipeline 训练随机森林三分类模型(240 棵树、最大深度 12),测试集 603 条样本上 Accuracy 0.9652、F1 0.9652、Weighted Precision 0.9655、Weighted Recall 0.9652,混淆矩阵与各项指标在界面与
/api/model/metrics中同步展示。 - 在线预测与发展潜力评估:表单录入 12 个类别选项 + 4 个行为数值(滑杆),实时输出预测成绩等级、各类别概率柱状图与 0-100 发展潜力仪表盘——潜力分由高等级概率折算,75 分以上为”高潜力”、50-75 为”中潜力”、50 以下为”待提升”;预测链路默认走 Spark Pipeline 推理,失败自动降级为基于数据距离的 Pandas 兜底,再失败则使用类别先验的应急兜底,保证功能始终可用。
功能截图
Streamlit-可视化大屏
Streamlit-模型评估与在线预测
FastApi