返回作品
基于 Spark 的交通事故分析与预测
创建于 2026 年 2 月 24 日
项目介绍
交通事故数据量大、字段杂、时空关联强,单机工具难以胜任全量分析。本项目基于 Apache Spark 构建完整的数据分析链路,以 Kaggle 公开数据集 US Accidents(2023 年 3 月版)为研究对象——该数据集包含约 770 万条美国交通事故记录、46 个特征字段,覆盖时间、地理位置、天气、道路设施等信息。系统面向”事故严重程度预测”这一核心问题,用 Spark 的分布式能力完成清洗、分析、建模的全流程。
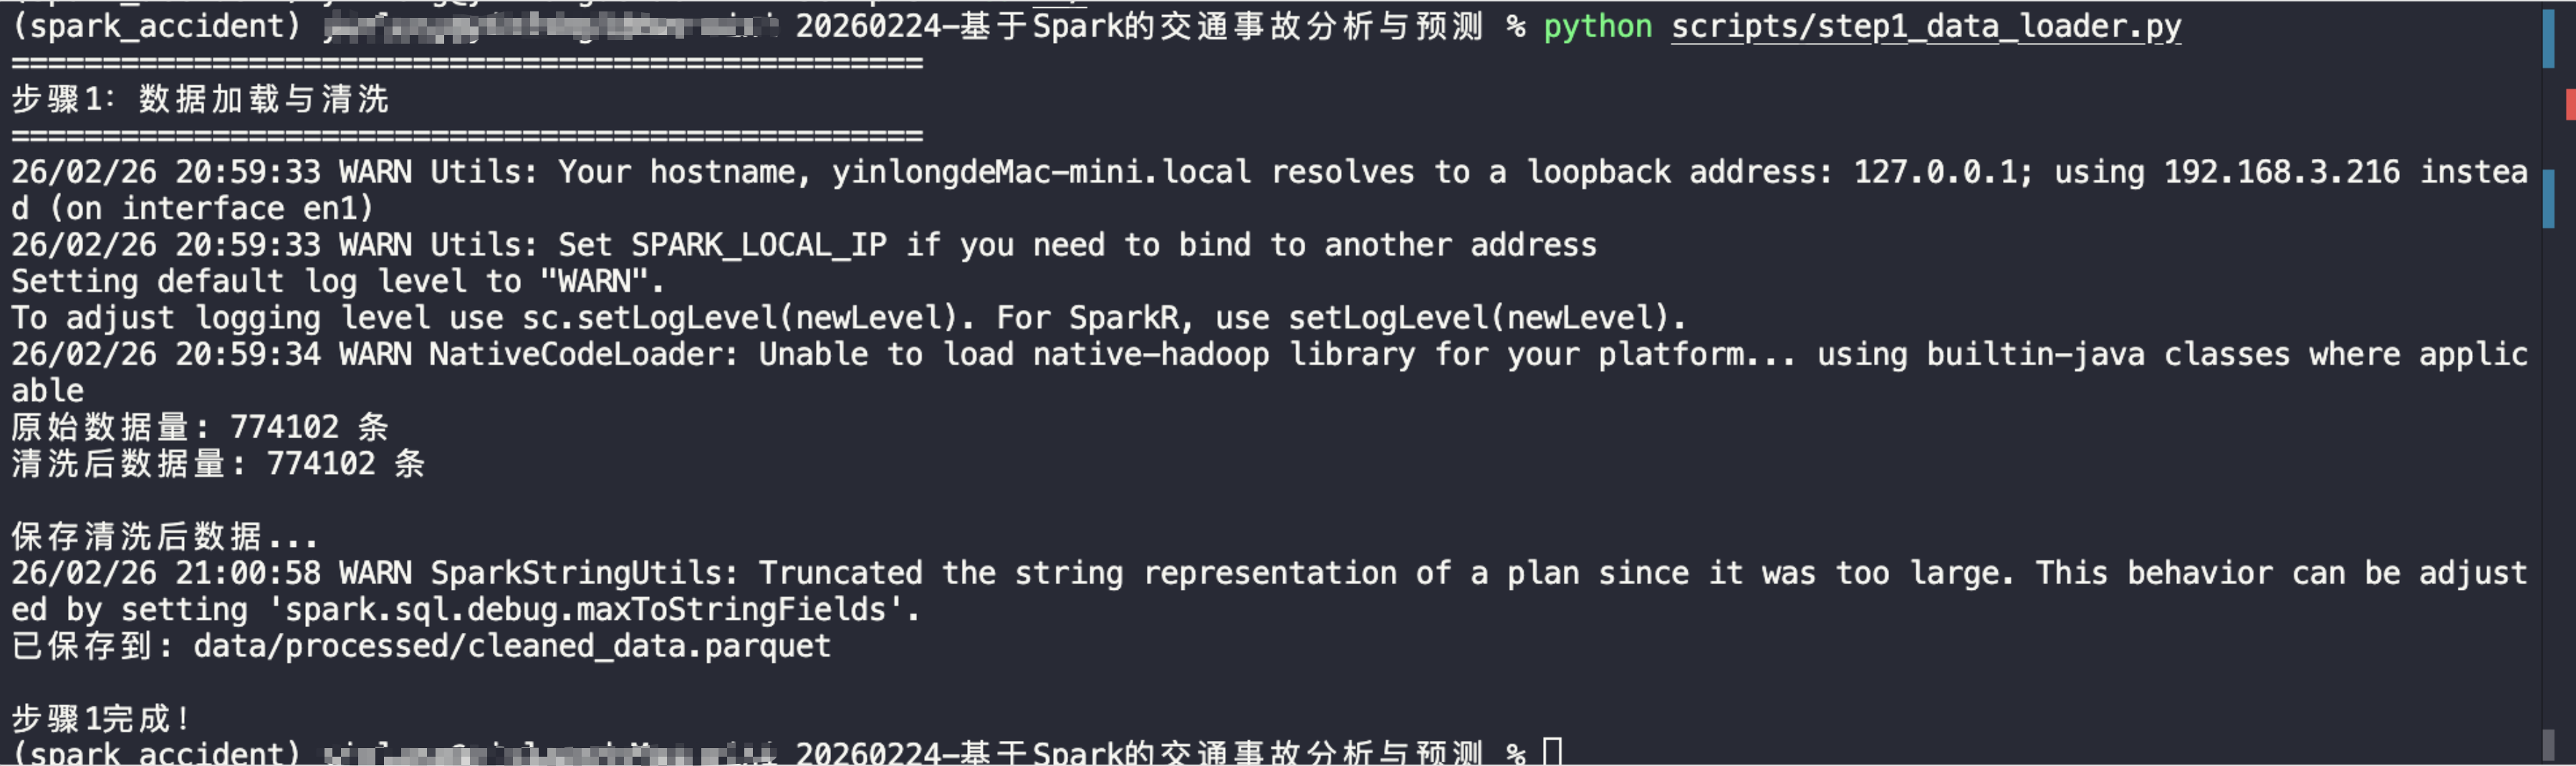
项目采用分步执行的工程组织方式:数据加载与清洗、探索性分析、特征工程与模型训练、Web 可视化四步各自独立成脚本,可逐步运行、随时检查中间产物。开发阶段通过 10% 采样(固定随机种子)快速验证流程,清洗后参与分析的记录数为 774,102 条,生产环境将采样比例调整为 1.0 即可全量跑通。
核心功能
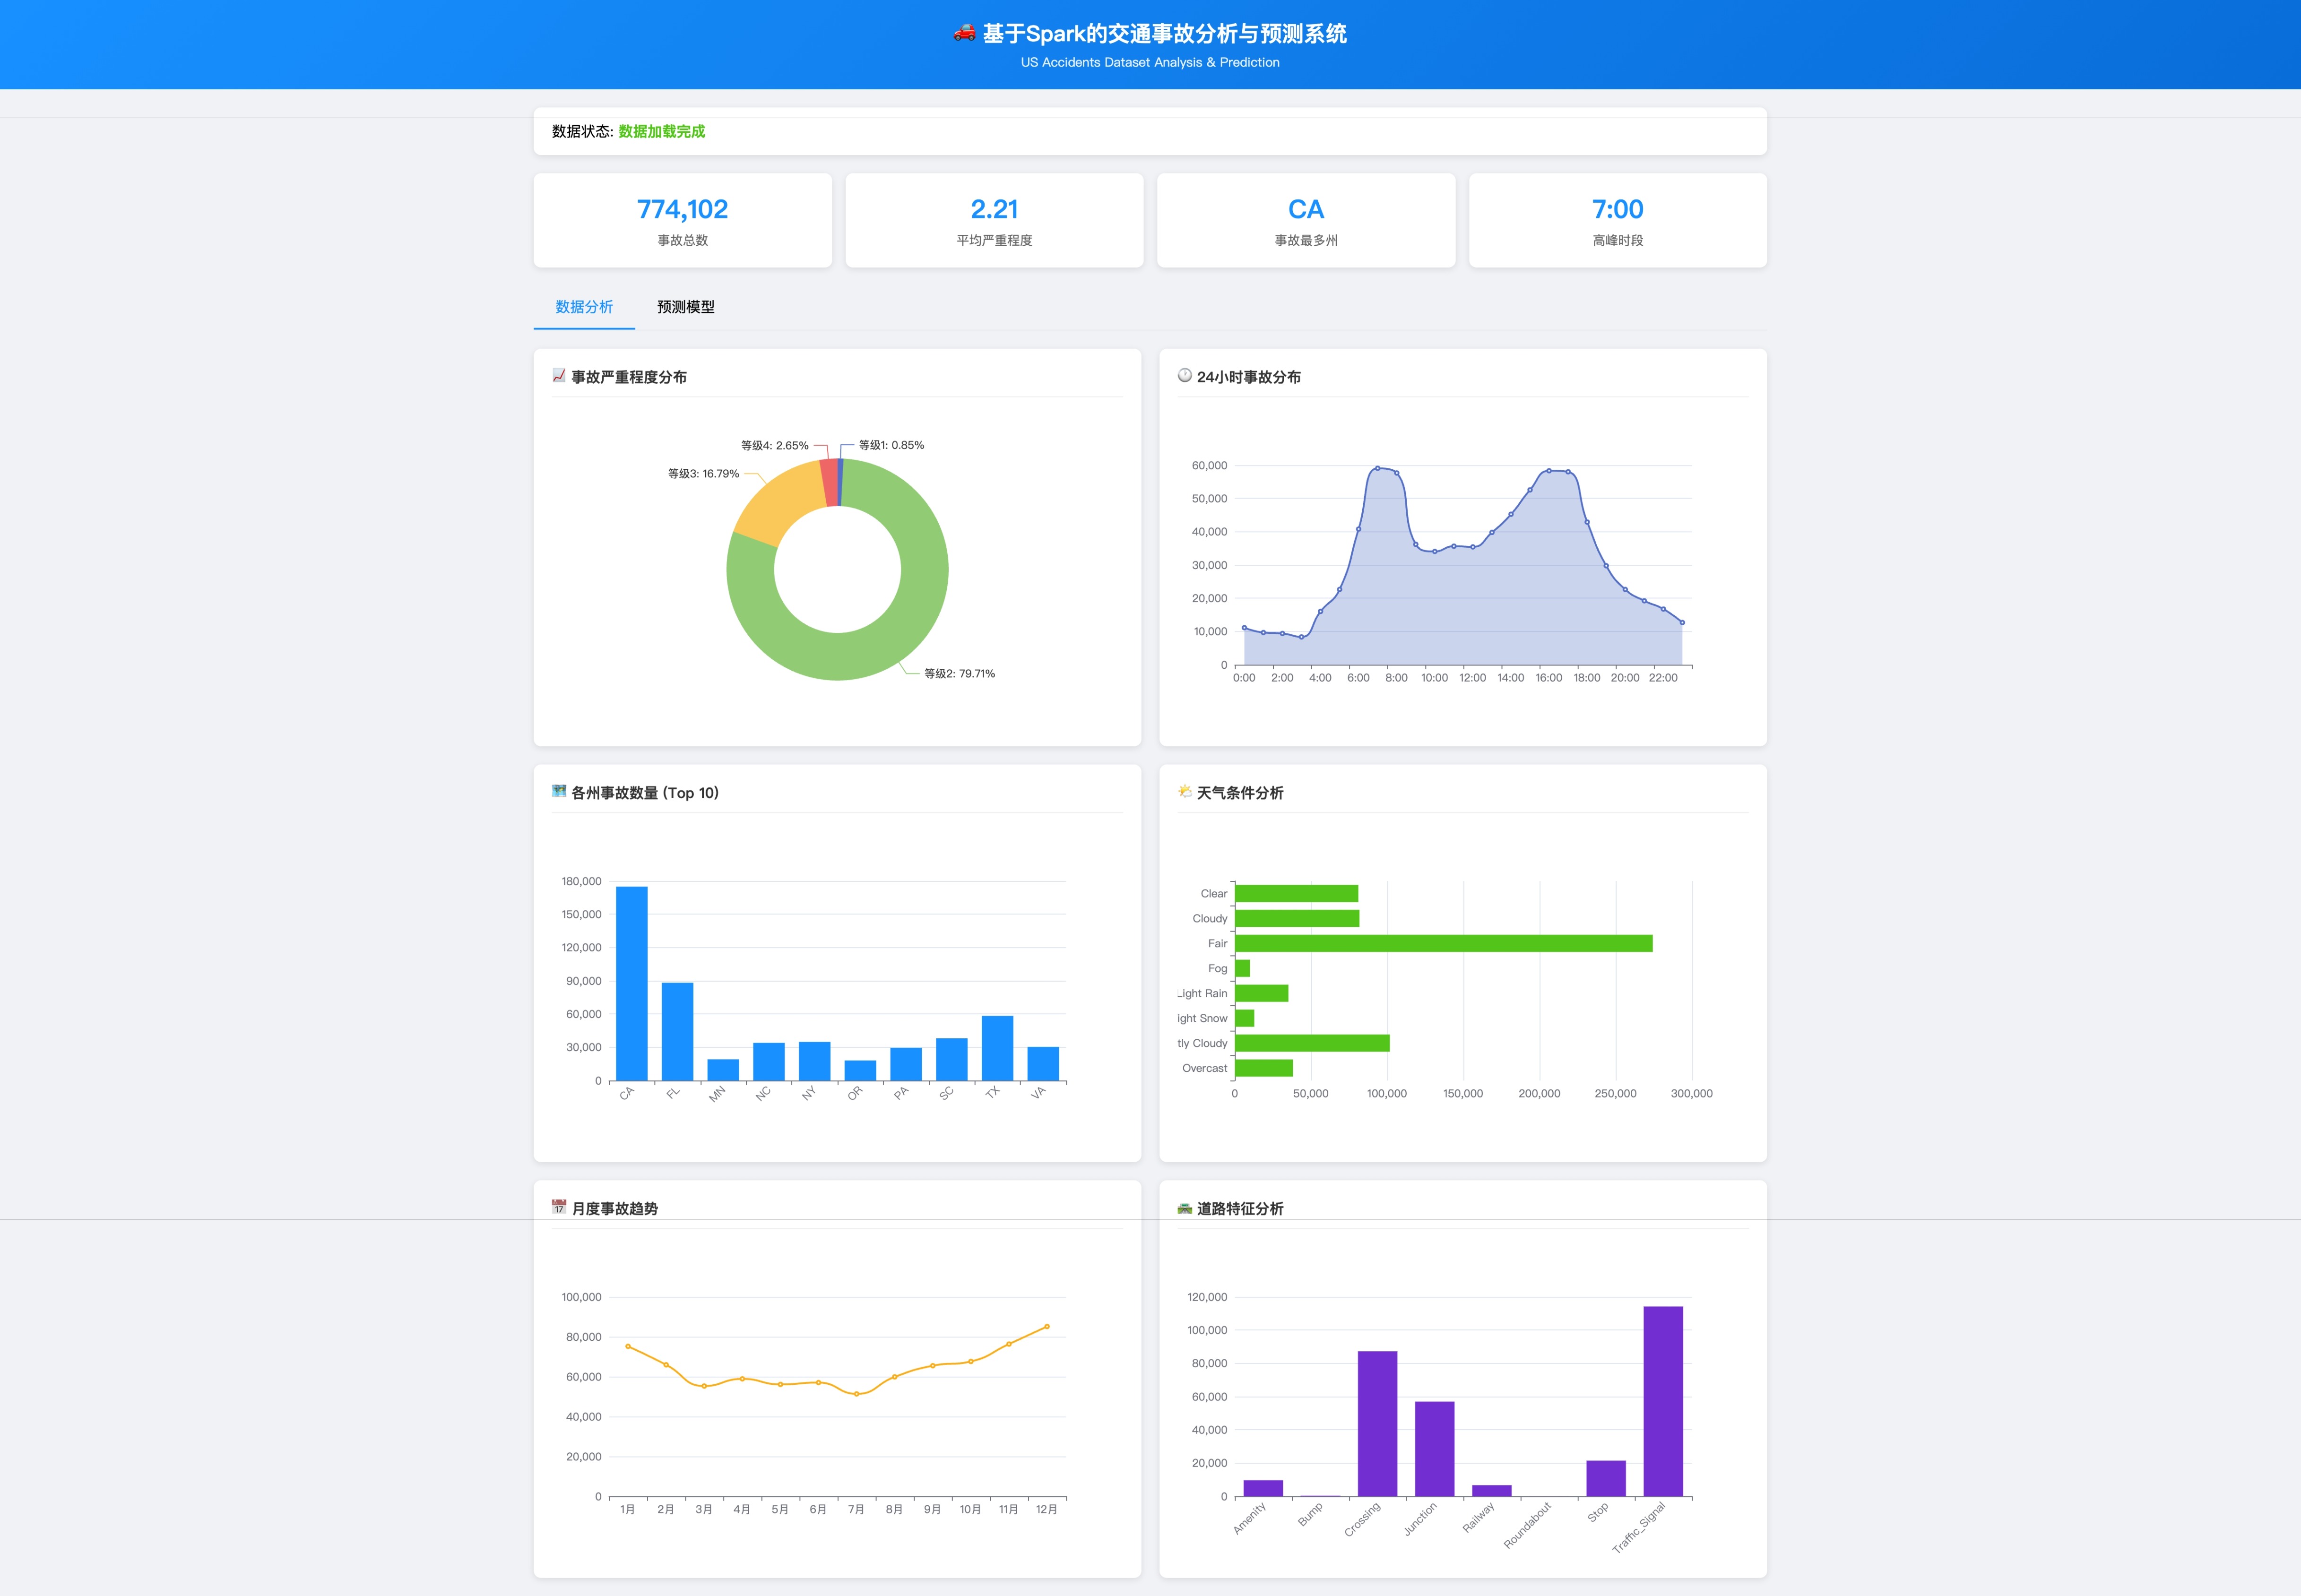
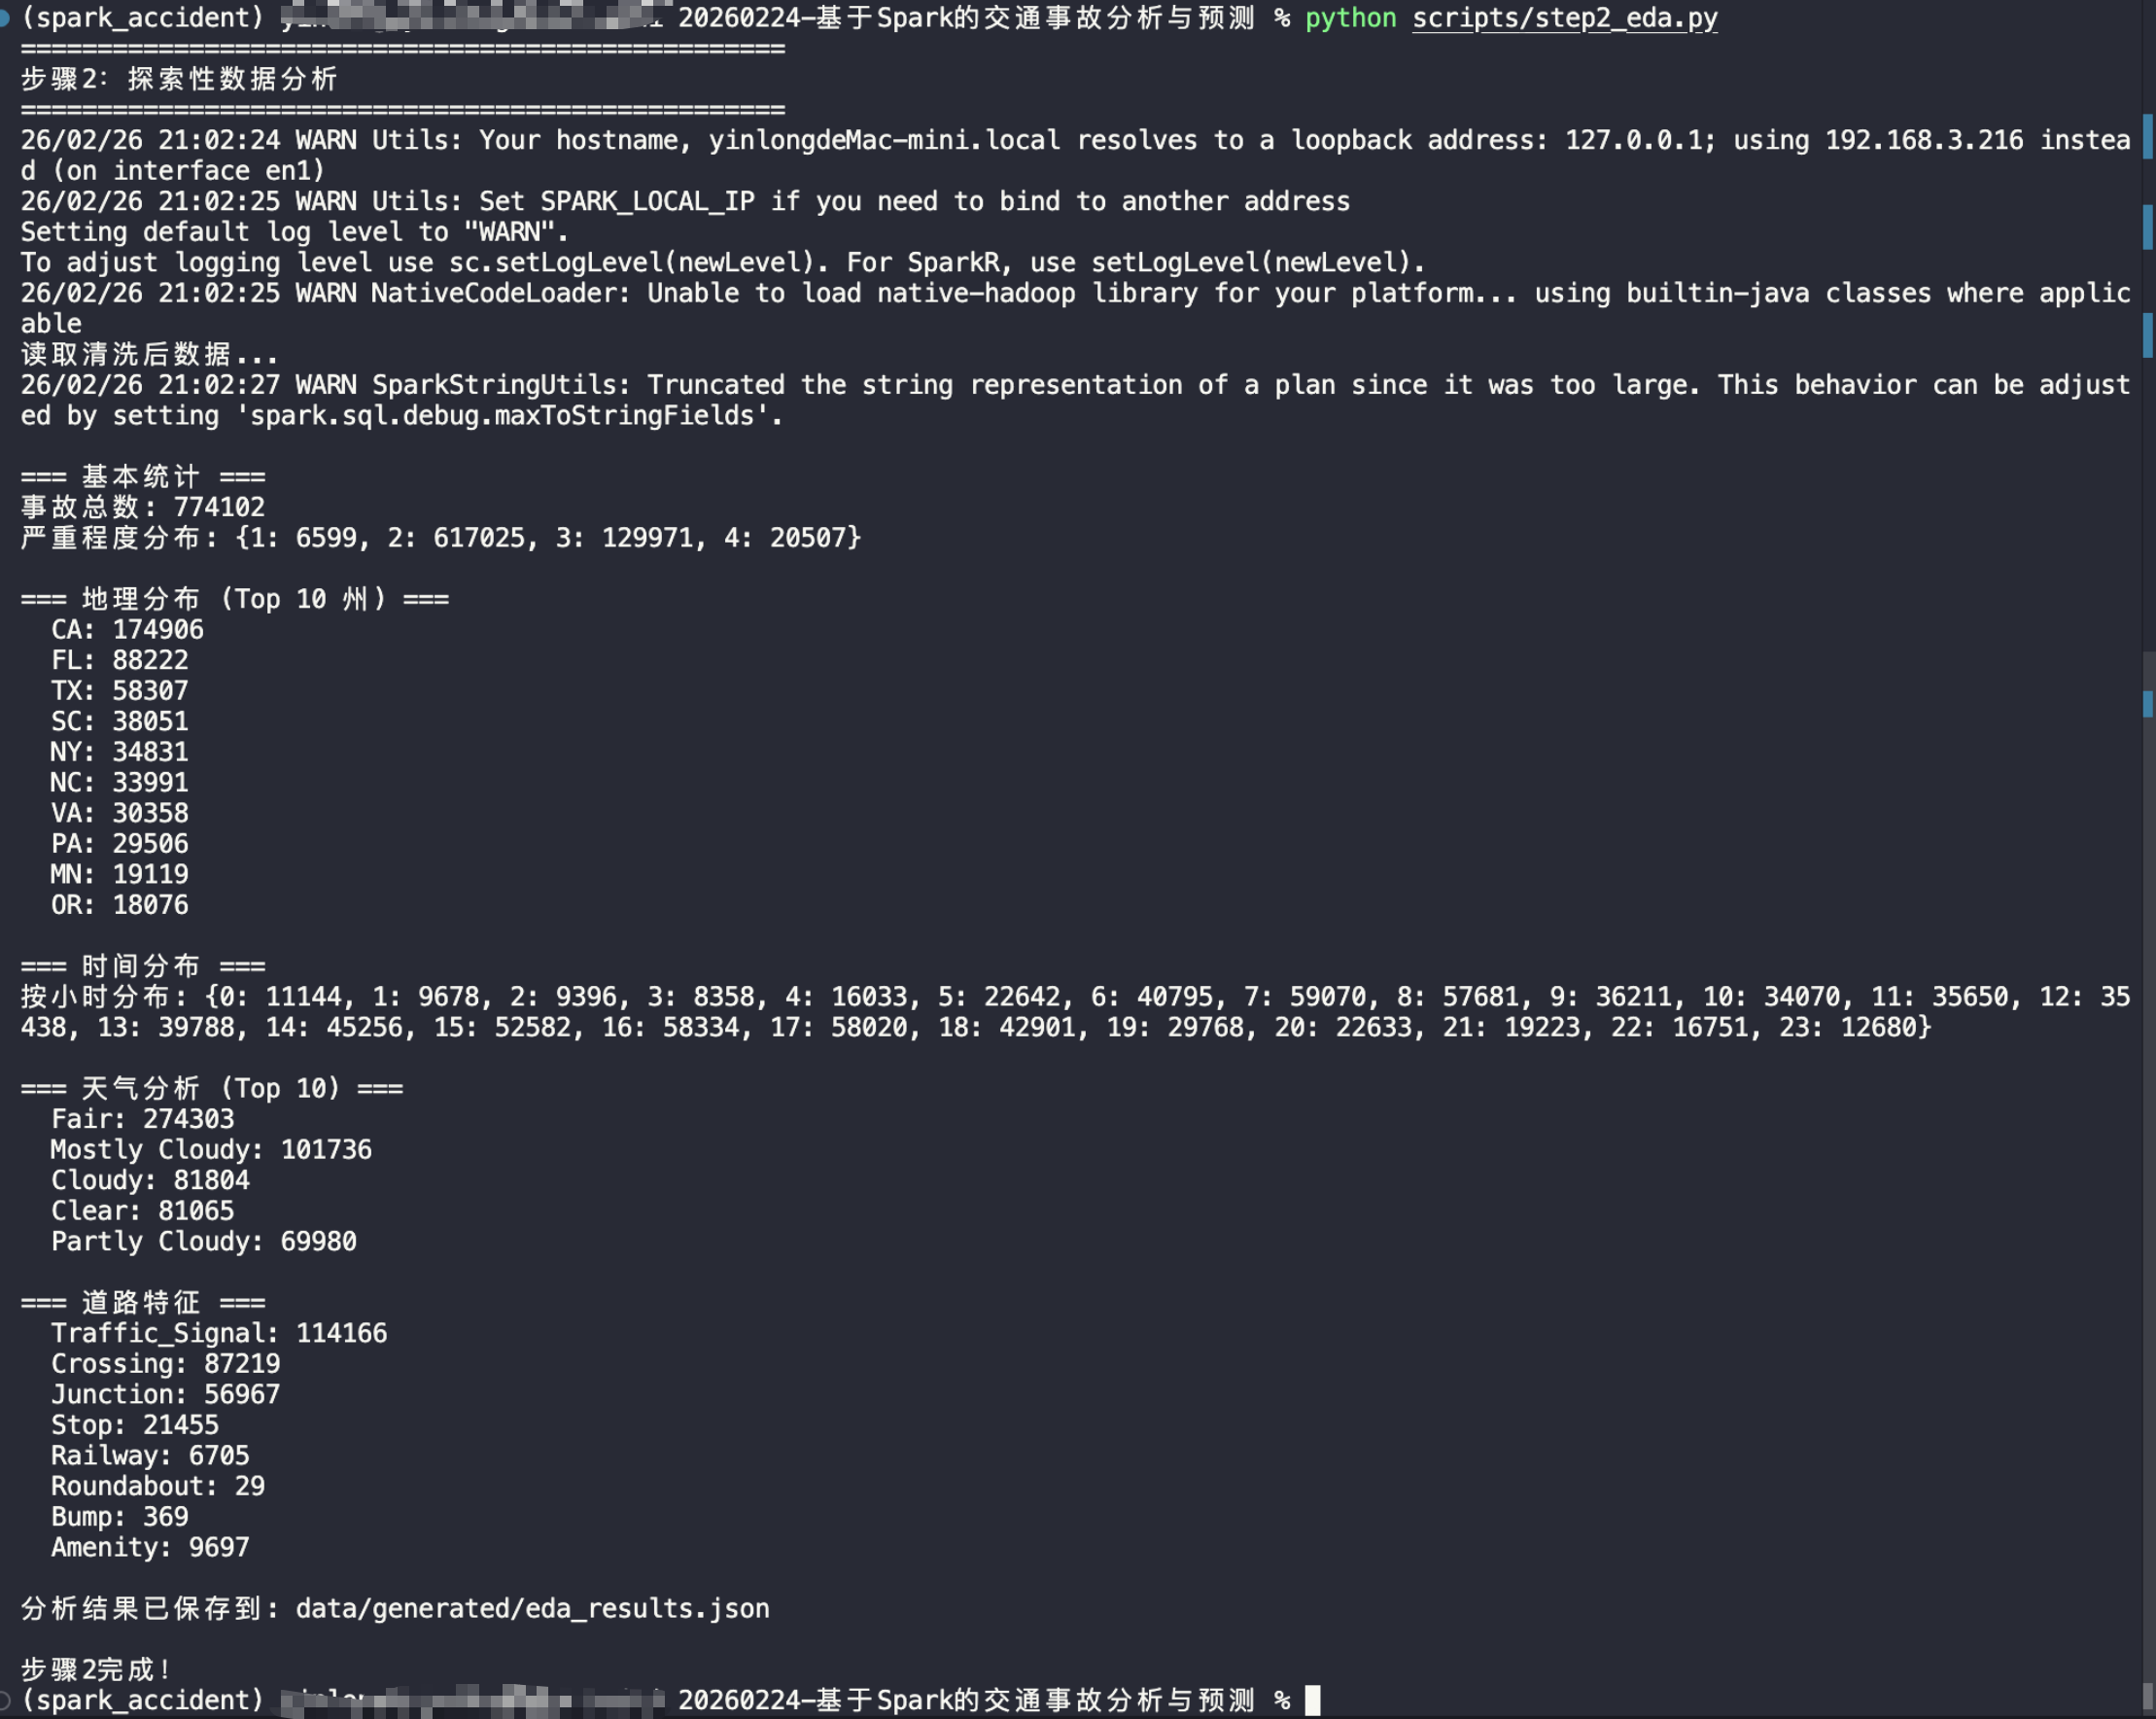
- 探索性分析:输出事故总数与严重程度分布(清洗后数据中 Severity 2 级占绝对多数:617,025 条)、按小时/月/星期的时序分布、Top 10 州与城市分布(加利福尼亚最多,174,906 条)、天气条件分布(Fair 天气 274,303 条居首)以及道路特征频次统计,并交叉分析光照条件、周末与否对严重程度的影响。
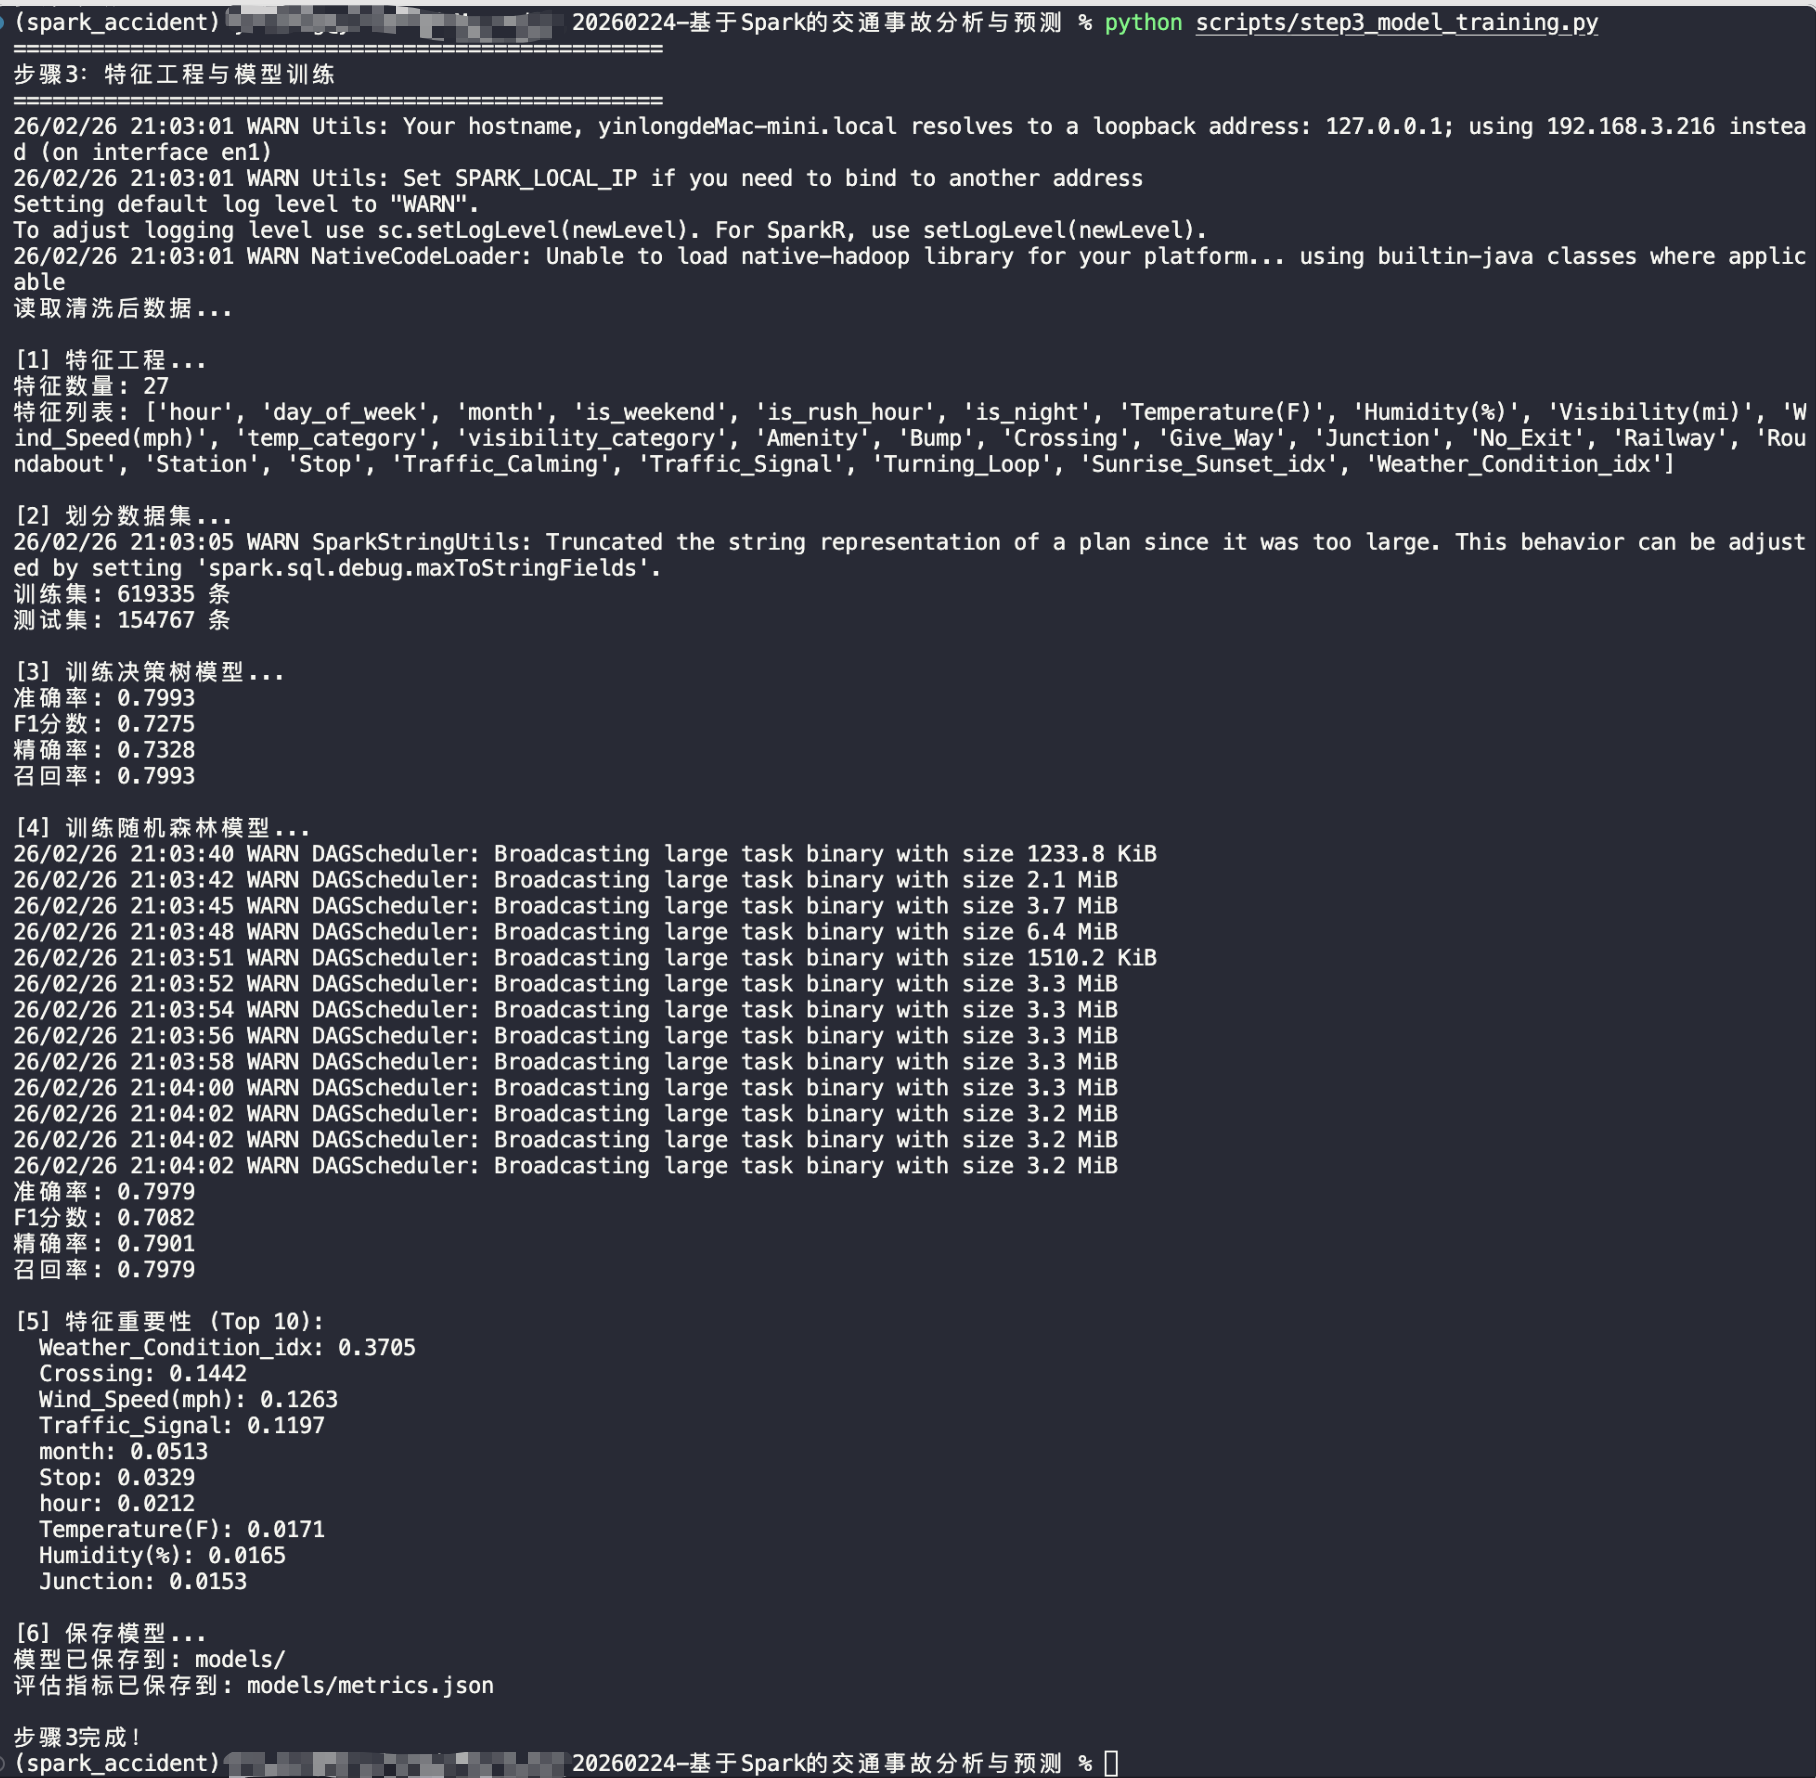
- 模型训练与评估:按 8:2 划分训练/测试集,训练决策树(maxDepth=10)与随机森林(50 棵树、maxDepth=10)两个分类器,输出准确率、F1、加权精确率、加权召回率与混淆矩阵;决策树准确率 0.7993、F1 0.7275,随机森林准确率 0.7979、F1 0.7082。随机森林特征重要性显示天气条件(0.3705)、Crossing(0.1442)、风速(0.1263)、交通信号灯(0.1197)是影响预测的最关键因素。另提供 3 折交叉验证(numTrees 与 maxDepth 参数网格搜索)寻找更优超参。
- 可视化界面:单页应用包含”数据分析”与”预测模型”两个 Tab,共 8 个 ECharts 图表(严重程度分布、24 小时分布、月度趋势、各州 Top 10、天气分析、道路特征、特征重要性、混淆矩阵),顶部另设事故总数、平均严重程度、事故最多州、高峰时段 4 张统计卡片。
功能截图
可视化分析页面
数据处理与建模步骤
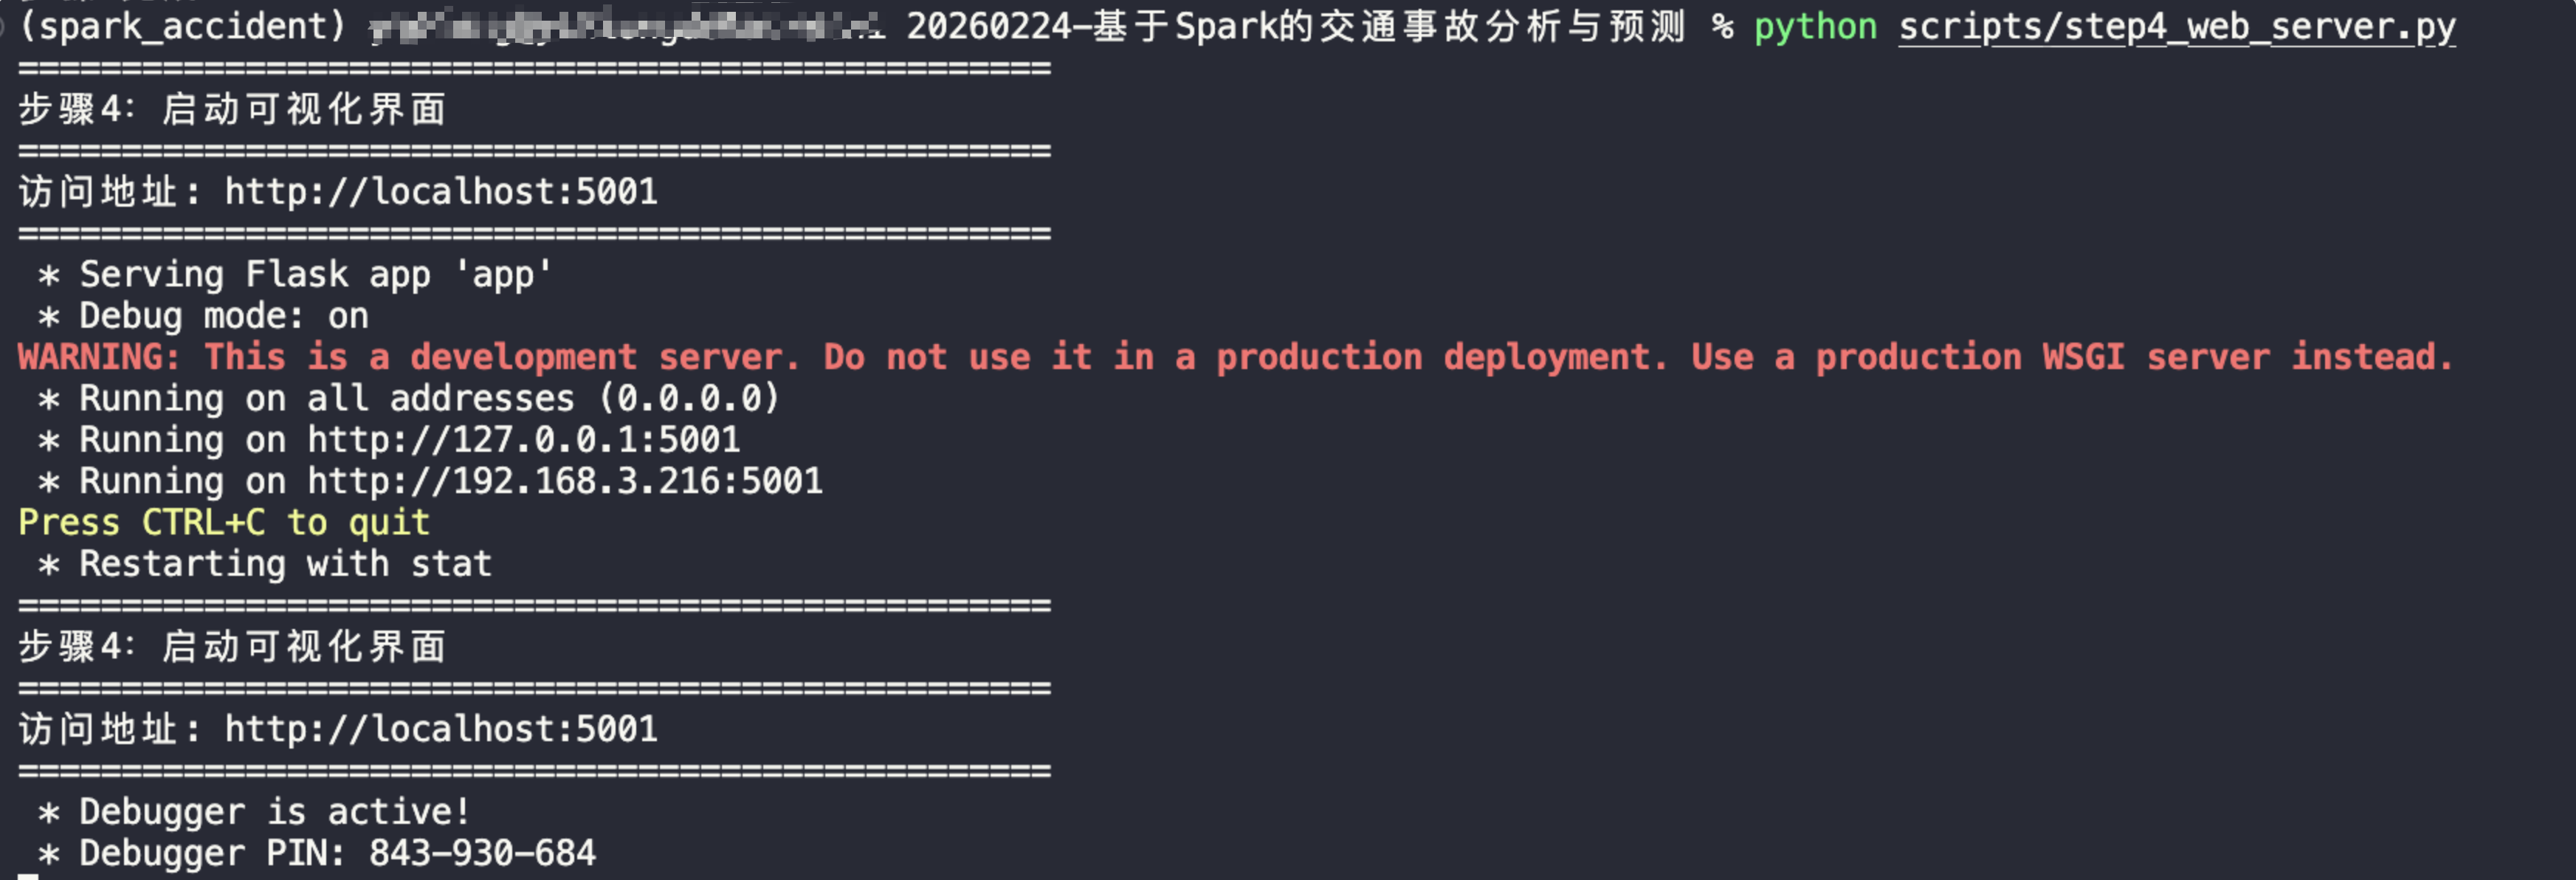
浏览器打开 http://localhost:5001 即可查看分析图表与模型指标;如果接口返回”请先运行 step2/step3”的提示,说明对应中间产物尚未生成。